Article
無審查模型怎麼選?LM Studio 新手教學,在自己電腦跑無審查 AI 模型
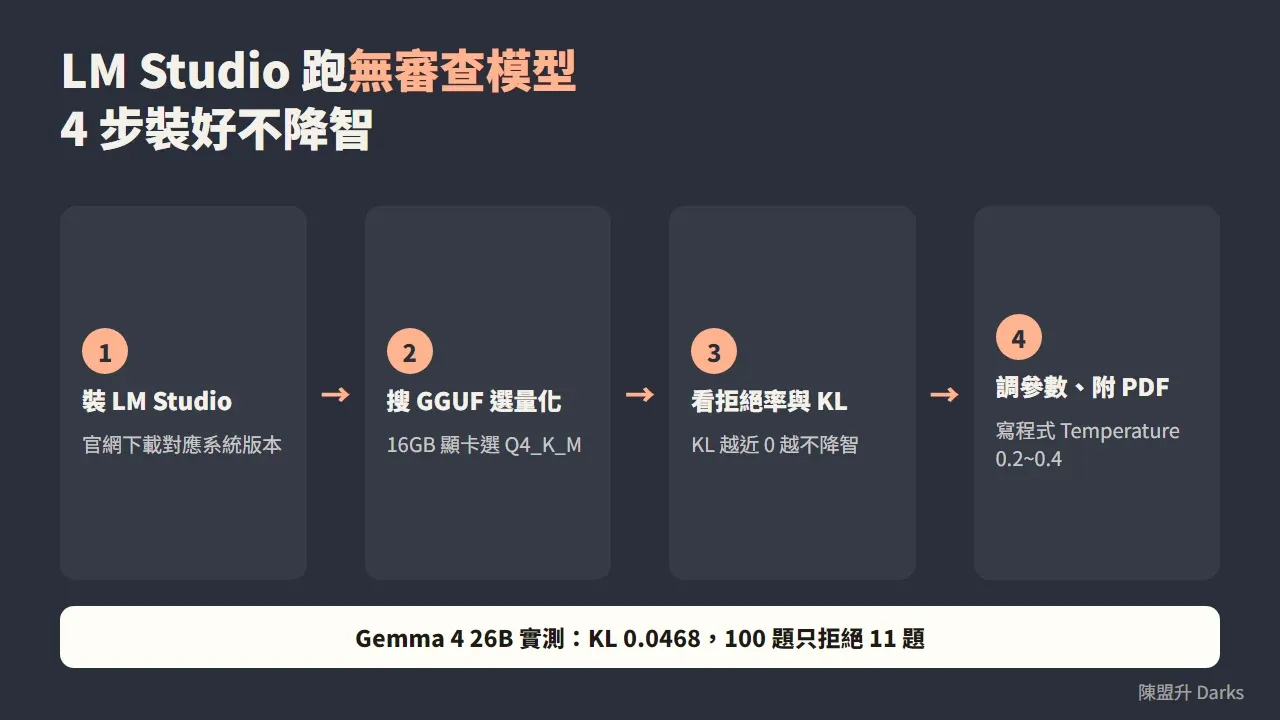
無審查模型是開源社群把原版模型的拒答行為調掉的版本,用 LM Studio 就能在自己的電腦上跑。新手只要三件事:裝好 LM Studio、搜尋 GGUF 格式的無審查模型、依自己的顯存或記憶體選量化大小。挑模型別只看參數量,要看拒絕回答率和 KL 散度,前者看它還會不會拒答,後者越接近 0 代表推理能力越沒被動到。資料全程留在你自己的電腦裡。
用 ChatGPT 或 Claude 這類雲端 AI 時,你大概遇過這種情況:只是想請 AI 分析競爭對手資料、看合約的隱私條款,或問一個稍微敏感但合法的商業問題,它卻回你「抱歉,我無法協助處理這項請求」。把商業機密、客戶名單貼到雲端,也會擔心資料被第三方伺服器記錄。
在自己電腦跑無審查 AI 模型可以解這兩件事。這篇是給新手的 LM Studio 教學,從安裝、找模型到怎麼用都寫在裡面,同類的本機模型也都能照同樣的流程處理。
無審查模型和無審查 AI 模型是什麼?
無審查模型(也有人叫未審查模型、Uncensored、Abliterated 版)是開源社群把原本模型的拒答行為調掉的版本。問一些雲端 AI 不肯回答的問題時,它比較願意好好回答。
這類模型不是官方發布的,是社群的大神們另外做出來的,品質差異很大,所以挑選方法比「下載哪一顆」更重要。
為什麼新手跑本地模型,我推薦 LM Studio?
跑本地模型的工具很多,常見的有 Ollama、vLLM 和 LM Studio。對不想碰命令列的新手,我推薦 LM Studio,原因有三個。
- 軟體內建模型搜尋,可以直接找到 Hugging Face 上的 GGUF 模型並下載,不用自己去網站找檔案。
- 溫度、上下文長度、GPU 卸載層數,都在側邊欄拉滑塊就生效。
- 在 Local Server 分頁按一下,就開出
http://localhost:1234/v1這個 OpenAI 相容的端點,能接進你自己做的 AI Agent 或 桌面地端 AI 助手。
Ollama 也能跑無審查模型。Ollama 可以用 ollama run hf.co/{帳號}/{模型庫} 直接執行 Hugging Face 上的 GGUF,不用另外寫 Modelfile。習慣命令列的人用 Ollama 也很順,我是因為想在介面上直接調參數才選 LM Studio。
想比較雲端和地端的差異,可以看 雲端 AI 與地端 AI 的選型指南。
實測挑選無審查模型:看懂「拒絕率」與「KL 散度」
很多人去 Hugging Face 搜尋 Uncensored 看到就下載,結果跑起來像個白癡一樣胡言亂語。社群在移除審查時,如果微調手法粗糙,很容易連推理能力一起破壞,俗稱「降智」。
我挑模型主要看兩個數字。
- 拒絕回答率:越低越不拒絕。
- KL 散度:越接近 0,代表推理能力越沒被動到。
以我實測過的 Gemma 4 26B 為例:
| 模型版本 | 標識名稱 | KL 散度 | 100 道測試題拒絕數 | 實測表現與建議 |
|---|---|---|---|---|
| 官方原版 | google/gemma-4-26b-it | 基準 (0.0000) | 100 題全拒絕 | 稍微敏感就拒答 |
| 普通無審查版 | gemma-4-26B-A4B-it-uncensored-heretic | 0.0468(損失極低) | 僅 11 題拒絕 | 我的主力,邏輯完整、回答精準 |
| 極限 Ultra 版 | gemma-4-26B-A4B-it-ultra-uncensored | 0.1237(稍有損失) | 僅 3 題拒絕 | 幾乎都回答,特定邏輯題稍有敷衍 |
日常使用我建議選普通無審查版,不要追求 0% 拒絕率。保留足夠的精度,模型才寫得出像樣的程式碼和商業分析。
換成別的模型也一樣,挑有公開拒絕率和 KL 散度的版本,比只看名字有 uncensored 可靠。
LM Studio 教學:4 步驟裝好無審查模型
Step 1:下載並安裝 LM Studio
到 LM Studio 官方網站,下載你的作業系統版本安裝就好。
Step 2:搜尋並下載無審查 GGUF 模型
在頂端搜尋框輸入模型名稱,例如 gemma-4-26B 或 uncensored。同一個模型會有好幾種量化版本,選法如下。
- 記憶體充足選
Q8_0或Q6_K。 - 顯存有限(例如 16GB 顯卡)選
Q4_K_M,速度與精度比較平衡。
Step 3:調整生成參數
載入模型後不要只用預設值,照模型作者的建議設定。寫程式或分析把 Temperature 設在 0.2 ~ 0.4,創意發想設 0.7 ~ 0.8;GPU Offload 盡量拉滿,讓模型多數層在 GPU 運算,速度比較快。
Step 4:開啟知識庫(RAG)
在對話框附加你的 PDF 或 Markdown 筆記。提問時,LM Studio 會檢索文件內容再交給本地模型回答,過程不需要連外網。
LM Studio 推薦模型怎麼選?依你的記憶體
新手最常卡在不知道自己的電腦跑得動哪一顆。下面是我的判斷順序。
- 先看顯存或記憶體有多大,模型檔案要放得進去,還要留一些空間給上下文。
- 同一個模型選量化版本:空間夠選 Q8_0 或 Q6_K,空間緊選 Q4_K_M。
- 如果還是放不下,換成同系列參數量更小的版本,比硬塞大模型再壓到很低位元更穩。
| 你的機器 | 我的選法 |
|---|---|
| 16GB 左右顯卡 | Gemma 4 26B 普通無審查版,量化選 Q4_K_M |
| 記憶體更小的機器 | 同系列較小參數版本,一樣挑有公開拒絕率與 KL 散度的 |
| 顯存和記憶體都很充裕 | 同一顆模型改用 Q6_K 或 Q8_0,精度更接近原版 |
我沒有測過所有機器,這張表是我實際用過的對應,實際能不能跑要以你的硬體為準。至於更大的模型,需要專門的引擎才跑得動,不是 LM Studio 這類工具直接載入,我之後另文介紹。
跑通無審查模型之後,下一步是讓它變成 Agent
光在介面裡打字聊天,只用到地端模型的一半價值。跑通之後,可以幫它接上手腳:
- 透過 LM Studio 的 Local Server,讓 Claude Code 或本機開發工具調用本地模型。
- 串接開源 Agent 框架,可以看 12 款免費開源 AI Agent 工具全覽。
- 地端模型容易跳針,可以看 地端 AI 模型總是跳針?套上 Harness。
把資料和 AI 的選擇權收回自己手上
花一個下午在自己的電腦裝好 LM Studio 和無審查模型,你就不必再受雲端平台規則變更的影響,商業資料也留在自己機器上。先從一顆大小合適的模型開始試,跑順了再往上加。
延伸閱讀
跟這篇相關、我也很常被問到的幾篇:AI Agent 是什麼、自己做的 AI Agent 怎麼維護。
常見問題 FAQ
LM Studio 推薦模型有哪些?要怎麼挑無審查模型?
不要只看參數大小,先看拒絕回答率與 KL 散度(越接近 0 代表推理能力越無損)。我在 Gemma 4 26B 的實測裡,挑拒絕率約 10% 到 20%、KL 散度 0.0468 的普通無審查版當主力。模型選好之後,再依自己的顯存或記憶體挑量化版本。
無審查模型要多少記憶體才跑得動?
看模型大小與量化位元。簡單的判斷方式是模型檔案要放得進顯存或記憶體,還要留一些空間給上下文。16GB 顯卡可以從 Q4_K_M 的量化版開始試,記憶體較小就改選同系列參數量更小的版本。
Ollama 可以跑無審查模型嗎?跟 LM Studio 怎麼選?
可以。Ollama 能用 ollama run hf.co/{帳號}/{模型庫} 直接執行 Hugging Face 上的 GGUF 模型,不需要另寫 Modelfile。我偏好 LM Studio,因為模型、上下文長度、GPU 卸載層數都能在介面調整,也能一鍵開出本機 API 給其他工具用。
什麼是無審查模型?下載時如何避免降智?
無審查模型(也叫未審查模型)是開源社群微調移除過度拒答限制的版本,不是官方發布。手法粗糙會讓推理能力下降,挑選時看拒絕回答率與 KL 散度,建議選拒絕率 20% 以下、KL 散度接近 0 的特化模型。
在 LM Studio 中如何給本地模型掛載專屬知識庫?
LM Studio 對話介面可以直接附加 PDF 或文字文件,讓模型參考內容回答(RAG),過程不需要連外網。若需要更進階的多文件管理,可以把 LM Studio 開成 Local Server,串接 AnythingLLM 或自製 Agent。