Article
地端 AI Agent 能做什麼?我把不想給雲端的工作交給本地 LLM 的實戰分工
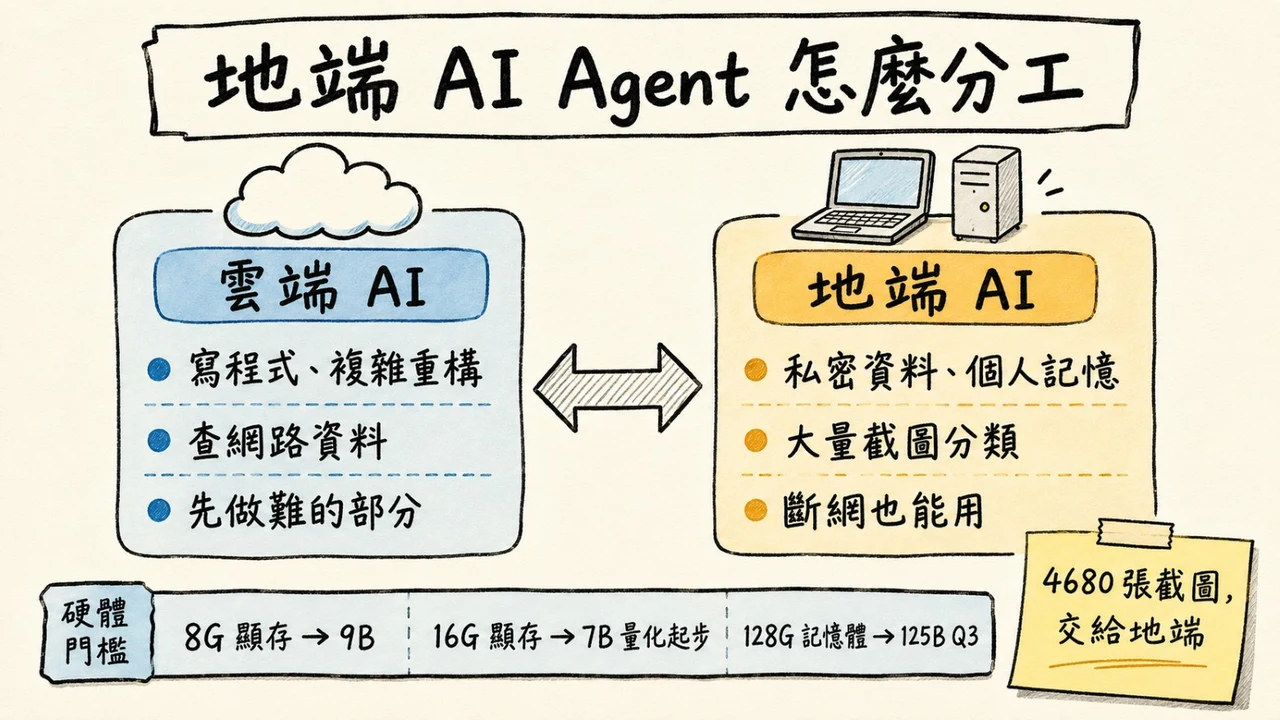
地端 AI Agent,指的是把開源大模型跑在自己的電腦上,讓它像 Agent 那樣讀檔、調用工具、照流程做事。我的分法是困難、精密的工作交給 Claude 等雲端模型,私密資料與簡單重複的工作交給地端。4680 張螢幕截圖的分類,我讓地端模型寫程式分批跑完。8G 顯存能跑 9B 模型,128G 記憶體能跑 125B 的 Q3 版。
如果你還不確定 Agent 和一般聊天 AI 差在哪,可以先看我寫的 AI Agent 是什麼,這篇會直接進到「地端要用在哪裡」。
地端 Agent 最適合做不想給雲端看的事
2026 年 10 月底,我終於處理了一件拖了快一年的事。電腦裡累積了 4680 張螢幕截圖,裡面可能有不適合交給雲端 AI 看的畫面,自己一張張分辨又太花時間,就一直放著沒做。
這個任務本身很單純,就是讓 AI 一張張判斷要丟還是要留。雲端和地端其實都做得到,但我比較放心讓地端看這批圖。
做法上有一個地方要注意。讓 AI 在對話裡一張一張看,非常浪費 Token。比較快的方式是讓它先寫一支程式,再由程式分批把截圖送進地端模型分類。
這支程式交給雲端 AI 寫也可以,因為寫程式只需要看幾張樣本,真正把截圖一張張看過的還是地端模型。我這次連寫程式都交給地端模型,整個過程沒遇到什麼問題。
同樣的做法也能套到別的情境,例如整理掃描的收據、分類手機相簿、幫私人筆記貼標籤。只要是「資料不想外流、判斷規則簡單、數量很多」的工作,都可以照這個方式試試看。
雲端和地端怎麼分工
我現在的分工大致是這樣。
| 工作類型 | 交給誰 | 我的理由 |
|---|---|---|
| 前沿開發、複雜重構 | 雲端(Claude Code) | 我覺得它寫程式和邏輯還是最頂尖,換地端做只會變慢 |
| 查網路資料、隨手問 | 雲端網頁版 App | 不碰本機程式碼,瀏覽器裡就能解決 |
| 私密資料、個人記憶 | 地端 | 行事曆、筆記、帳本留在自己的電腦 |
| 已跑通的重複流程 | 地端 | 省雲端額度,難度也在地端能做的範圍 |
| 雲端模型不願意做的事 | 地端 | 本來做不了的工作,換成地端就能做 |
2026 年 10 月下旬到 11 月初,我花了兩週把這套分工搬進筆電。我自己做的 AI Agent 本來是純地端的,有自己的一台電腦隨時在工作;現在它可以和我筆電上的 Claude Code 在同一個環境裡合作。大量或精密的工作交給 Claude,大部分的事也是 Claude 在做,比較私密的、或 Claude 不願意做的,就交給地端接手。
地端現在跑的是 125B 的 Q3 版本。畢竟只有 128G 記憶體,當然沒有雲端聰明,但我分配給它的工作它都還能勝任。因為困難的部分 Claude 已經先做完,剩下的是簡單、重複的工作,所以就算換成 35B、27B 的模型,效果也還不錯。
我在 2026 年 11 月又往前走了一步,把地端模型和雲端模型拉進同一個聊天室。地端遇到做不到的事,會主動請雲端模型幫忙,但要不要讓雲端接手,由我按同意。地端模型偶爾會脫線,所以我不會把工具全部開給它,會加不少安全限制。
想更細看雲端與地端的優缺點、免費額度怎麼用,可以看 雲端 AI vs 地端 AI 怎麼選。
為什麼我堅持要有地端這條線
我希望自己的 AI Agent 夠懂我,能把分散在各處的行事曆、筆記和工作需求串起來。這些資料我想留在自己的電腦,所以個人記憶全部存在地端。
另一個原因是斷網。我給自己訂的要求是,網路斷掉時,所有 AI 功能還要能用。雲端模型再強,斷網就用不到了。
我也很早就開始累積個人記憶。開源模型和雲端模型都會一直變強,但如果自己沒有資料累積,再強的 AI 也沒辦法憑空懂你。
如果你沒有太多客製化或斷網的需求,直接用 OpenClaw、Hermes Agent 這類現成的開源工具就能很快上手,不需要像我一樣自己寫。
硬體門檻,先看顯存和記憶體
本機跑模型最大的瓶頸是顯存(VRAM)。顯存裡除了要放模型本身,還要留一塊 KV cache 記住對話上下文,上下文越長,吃得越多。
顯存不夠時就靠量化。量化是把模型參數的精準度調低來壓縮體積,例如原本全精度要 14GB 的模型,換成 4-bit 量化大約剩 3.5GB。一般對話和助理任務的品質損失通常不大。
以下是我自己用過或實測過的組合,給你當起點參考。
| 你的硬體 | 我建議的起點 | 我的實測心得 |
|---|---|---|
| 8G 顯存的遊戲顯卡 | 9B 模型的 4-bit 量化版 | Qwythos-9B 工具調用意外地好,基礎聊天、討論都沒問題 |
| 8~16G 顯存 | 7B 模型 4-bit 量化版,Mistral、Qwen、GLM 都可以 | 用 llama.cpp 或 LM Studio 起步最快 |
| 顯存夠跑 26B、35B | 直接用中型模型 | 這個等級就不需要 9B 了 |
| 128G 統一記憶體(我用 GB10) | 125B 等級的 Q3 量化版 | 我現在的主力地端模型,簡單重複的工作都能勝任 |
設備的速度差別也要自己量過才準。2026 年 11 月我把 GB10 上的工具搬到 MacBook M5 Max 128G,用同樣的模型和參數各跑一次。LLM 我測的是 Qwen 3.8 Next,Mac 快約 1.8 倍;生圖、語音轉文字和文字轉語音,照原本的跑法反而是 GB10 快兩到四倍。後來我把語音模型換成 Mac 專用的 MLX 版,語音轉文字就反過來變成 Mac 比較快。所以要買設備前,先想清楚自己主要拿它跑什麼,再查那些模型在這顆晶片上有沒有適合的引擎。
想試沒有審查限制的開源模型,我在 LM Studio 本機無審查模型實測 寫了怎麼挑不會變笨的版本。
小模型當 Agent 的三個注意事項
小顯存的模型可以當 Agent 用,但要調整用法。我實測 Qwythos-9B 這類 9B 模型,整理出幾個常踩的地方。
第一個是上下文。官方號稱支援一百萬上下文,但我實測開到 5、6 萬就是極限,再高就容易被汙染,忘記自己原本在做什麼。
第二個是命令要單一。不要一邊叫它工作、一邊跟它閒聊,不然很快就會開始跳針。用 OpenClaw 或 Hermes Agent 的話,可以用 /btw 在主對話之外插話,讓主任務的命令保持單純。
第三個是別期待它寫程式。寫程式有很多好用、便宜甚至免費的雲端工具,8G 跑 9B 來寫程式效率很低。它比較適合當離線備援,查電腦裡的檔案、串接私密帳本、做翻譯。
地端模型工具呼叫會跳針,很多時候是外面的流程沒有幫它鋪好路。這部分我在 地端 LLM Harness 指南 有完整說明。
先拿一件簡單、重複的工作開始
我的建議是先別想著用地端取代雲端。挑一件你手上「資料不想外流、規則簡單、數量很多」的工作,讓地端模型跑一輪,例如整理一個資料夾的截圖。
跑完之後你會知道,自己的硬體配上哪個大小的模型,做這類工作夠不夠用。每個人的情境和設備都不同,親自實驗過一次,比看任何排行榜都準。
常見問題 FAQ
地端 AI Agent 適合做哪些事?
我自己用在兩類工作。一類是不想交給雲端 AI 的資料,例如私人截圖、行事曆、帳本和電腦裡的檔案;另一類是流程已經跑通、只是量很大的重複工作,例如把 4680 張截圖分成要丟和要留。寫程式、複雜重構這類吃聰明度的工作,我還是交給雲端模型。
雲端 AI 和地端 AI 要怎麼分工?
我的做法是困難、精密的部分先讓 Claude Code 做完,剩下簡單、重複的工作再交給地端模型。比較私密的內容,或雲端模型不願意做的內容,就由地端接手。這樣能省下雲端額度,難度也落在地端模型做得到的範圍。
跑地端 AI Agent 需要什麼等級的電腦?
8G 顯存的一般遊戲顯卡就能跑 9B 等級的模型,可以做工具調用和基礎聊天;8~16G 顯存適合從 7B 的 4-bit 量化版開始。我自己用 128G 記憶體的 GB10 跑 125B 的 Q3 量化版。顯存越大,能跑的模型越大,但還是建議用自己的實際工作去測。
小模型開很大的上下文會怎樣?
上下文開越大,顯存和記憶體就吃越多。我實測 9B 模型開到 5、6 萬上下文就是極限,再高就容易忘記自己在做什麼、開始跳針。每次給它單一、明確的命令,會穩定很多。