Article
地端 AI 推薦配置:128GB 記憶體的電腦怎麼配模型,我養了快一年的 AI Agent 整套給你抄
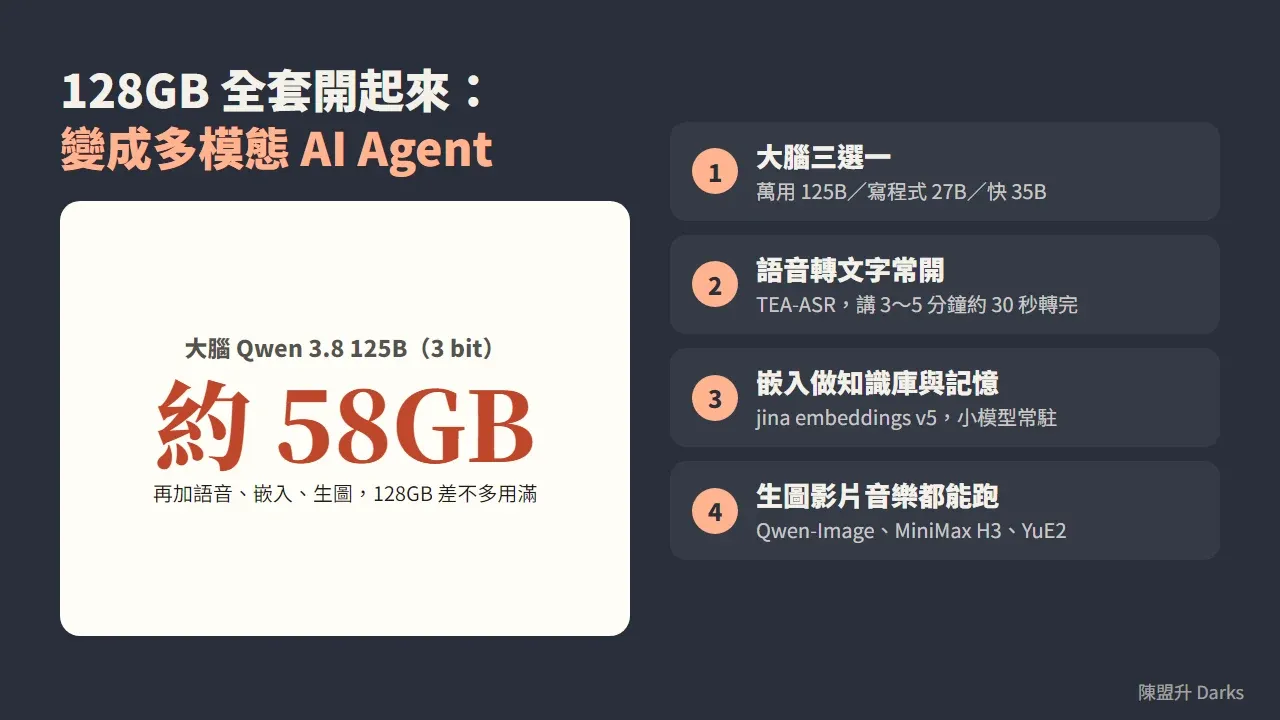
地端 AI 要買什麼電腦,我的答案是 128GB 統一記憶體。我用這個等級的機器養 AI Agent 快一年,大腦從三顆模型挑一顆常駐,再同時開語音轉文字、語音合成、嵌入和 ComfyUI 生圖,一台 128GB 就變成能語音溝通、看圖、生圖、寫程式的多模態 AI Agent。記憶體決定能不能載入,頻寬只影響快慢,所以先看容量。
這篇是我這一年的整理,所有速度與記憶體數字都是我在自己機器上量的。如果你想先知道地端 Agent 能幫你做什麼,可以先看 地端 AI Agent 能做什麼,這篇專心講「怎麼配」。
地端 AI 是什麼?為什麼我要自己養一台
地端 AI 就是把開源模型跑在自己手上的機器,不經過雲端平台。對我來說,擁有一台 128GB 的設備等於有一份底氣:不用看平台臉色,不用擔心訂閱方案突然調整。128GB 足以容納一個 AI Agent 需要的一切,就算完全斷網,我還是有一個離線的私人 Agent。
我不會叫你全部搬回地端。難的工作我還是交給雲端模型,雲端和地端怎麼分,我寫在 雲端 AI vs 地端 AI 怎麼選。地端留給兩種事,一種是不想上傳的私人資料,一種是流程跑通後量很大的重複工作。
如果你還不清楚 Agent 跟一般聊天機器人差在哪,先看 AI Agent 是什麼。
地端 AI 電腦要看哪三個規格?
挑地端 AI 電腦,我依序看這三項,重要程度差很多。
| 規格 | 決定什麼 | 我的看法 |
|---|---|---|
| 記憶體容量 | 模型能不能載入 | 最優先,塞不進去就直接失敗 |
| 記憶體頻寬 | 生成速度的上限 | 第二順位,但不是全部 |
| 硬碟 | 存模型和檔案 | 跑模型時用不到,夠放就好 |
容量為什麼最優先?因為模型必須整個放進記憶體才能正常運作。我看過的情況是,Mac 塞不下時會拿硬碟當虛擬記憶體,生成速度從每秒二十幾個 token 直接掉到零點幾,整台卡住。
「速度上限約等於頻寬除以模型大小」是個好記的估算。8B 模型壓成 4 位元約 4GB,放在頻寬每秒 153GB 的 M5,理論上限每秒約 30 多個 token;放在頻寬每秒 614GB 的 M5 Max,約 150 個。實際大多能跑到理論值的五到八成。
不過頻寬大不等於全部都快,這點我後面用實測數字說明。
128GB 的機器有哪些選擇?
這個等級的機器,我自己兩種都用過,另外還有一類剛上市的。
| 機器 | 記憶體 | 頻寬 | 我的使用經驗 |
|---|---|---|---|
| DGX Spark(GB10) | 128GB LPDDR5X 統一記憶體 | 273 GB/s | 我買的,相容 CUDA,ComfyUI 之類的工具裝起來最省事 |
| MacBook Pro M5 Max | 128GB 統一記憶體 | 約 614 GB/s | 我的筆電,文字生成最快,可以帶著走斷網用 |
| RTX Spark Windows 筆電 | 最高 128GB | 第三方分析約 300 GB/s | 2026 年 10 月 16 日起由多家品牌發售,我沒有實測過 |
RTX Spark 的規格來自 NVIDIA 官方產品頁 與 PCWorld 的 ASUS ProArt P16 評測。評測提到統一記憶體會分給系統與 GPU 各一部分,買之前要確認 GPU 實際能用多少,也要留意 Windows on Arm 的軟體相容性。這類筆電我沒有自己跑過,所以只給你查證方向,不給我的數字。
我自己的取捨很簡單。需要帶著走、要斷網單機用,就選筆電;放在家裡長時間跑,桌機型比較穩,因為筆電滿載跑半小時左右會降頻。
地端 AI 的大腦怎麼選?三顆模型我都用過
大腦就是大語言模型,三個吃的記憶體不一樣,挑一個常駐就好。
| 模型 | 適合什麼 | 預加載 | 推理 | 我的評價 |
|---|---|---|---|---|
| Qwen 3.8 125B | 最萬用,什麼都能丟 | 上下文十幾萬時仍破千 token/秒 | 30 到 50 token/秒 | 最聰明,記憶體吃最多 |
| Qwen3.8 27B | 寫程式、需要嚴謹的事 | 500 到 1000 token/秒 | 10 到 20 token/秒 | 速度慢,但寫程式我用起來最穩 |
| occamy 1.0 35B | 要回話快 | 沒有另外量 | 最快 | 佔記憶體小,寫程式弱、常有 bug |
125B 我用 Strata 這個推理引擎跑,能省很多記憶體。occamy 寫出來的程式有一堆 bug,但把 Harness 調好之後,它當 Agent 的大腦仍然能用,回話速度和小記憶體就是它最大的優點。Harness 怎麼調,可以看 本地 LLM 的 Agent Harness 實戰。
我的習慣是平常開一個,工作型態換了再換。量化選擇則取決於你要多快的速度和多好的品質,沒有標準答案,拿到機器後多試幾種量化等級,找出你自己能接受的組合。
125B 的實測數字,GB10 和 MacBook 差在哪
我把同一顆 Qwen3.8-Flash-Next 無審查版放到兩台機器上,都開 262K 上下文當 Agent 大腦。無審查版是開源社群的大神們改出來的,我自己用在處理不想交給雲端的資料。
| 機器與模型 | 生成速度 | 讀 6.4 萬 token | 記憶體 |
|---|---|---|---|
| GB10,Swift 1.5 的 3 bit | 每秒 43 到 50 | 約 30 秒 | 約 58GB |
| MacBook,Swift 1.5 的 3 bit | 每秒 82 到 93 | 約 45 秒 | 約 78GB |
| MacBook,Orca 的 5.7 bit | 每秒 61 到 92 | 約 39 秒 | 最高約 94GB |
5.7 bit 是 128GB 的 Mac 放得下的最大版本,位元越高越接近原版。我的體感是品質差很多。最初沒設定好的時候,Agent 用 Mac 上的模型叫工具一直被退回,3 bit 會直接卡住,以為自己做完了;5.7 bit 卻能發現工具有問題,轉頭向我回報並請我協助。
長文讀得慢的問題,我用快取補。讀過的對話會存進硬碟,我實際聊到 8.9 萬 token,第一句讀 56 秒,下一句 0.75 秒就開始回。我的 Agent 優化後快取率有 93%,所以只有首次載入慢,之後持續對話就很快。
我兩顆都留在 Mac 上。要生圖就切 3 bit,不需要就用 5.7 bit。
語音、嵌入、生圖,哪些要常開?
大腦只是一部分,要做成能對話、能做事的 Agent,還要搭這幾個小模型。
語音轉文字要常開
我跟 AI 一起開發、跟 Agent 交代事情,大部分都是直接用講的,所以 STT 一定常開。我用的是 TEA-ASR,繁體中文識別效果很好,中英夾雜也能應付。我常常一次講 3 到 5 分鐘,轉錄約 30 秒,短句更快。
文字轉語音看需求
要讓 AI 開口說話才需要開。我手上有 GPT-SoVITS、OmniVoice、VoxCPM2 輪流用,不同音色和速度差很多,我習慣用最快的。要錄影片配音,就挑音色好、穩定度高的。不需要它說話就關掉,記憶體讓出來。
嵌入模型是知識庫和 Agent 記憶的地基
向量資料庫靠嵌入模型把文字轉成向量,我用 jina embeddings v5。你想把自己的文件做成搜得到的資料庫,或讓 Agent 記得之前聊過什麼,都要靠它。模型很小,我在 Mac 上量到佔約 1.6 到 1.7GB,常駐不心疼。
ComfyUI 生圖、影片、音樂
GB10 相容 CUDA,ComfyUI 這類工具大多以 CUDA 為主,裝起來最省事。我常用的清單如下。
| 用途 | 模型 | 說明 |
|---|---|---|
| 圖片編輯 | Qwen-Image 2.1 | 改圖、換視角、去背 |
| 圖片生成 | Qwen-Image 2.1 或 Krea2 | 看你要的風格 |
| 影片生成 | MiniMax H3 | 給一張首幀就能做出帶聲音的短影片 |
| 音樂生成 | YuE2、ACE-Step 1.5 | 歌曲、純音樂都行 |
最近我也在試圖片轉 Live2D 和圖片轉 3D 建模,ComfyUI 都有對應的模型和工作流。這類模型一般比文字模型更吃算力,所以後面會講兩台機器的差異。
全部開起來,128GB 就是一台多模態 AI Agent
128GB 的好處是不用開一個關一個。我常態開著 Qwen 3.8 125B、生圖、STT、TTS 和嵌入,全部開起來記憶體也差不多用滿了,但換來的是一台本地的多模態 AI Agent,能語音溝通、看圖、生圖、寫程式、自動化、處理日常工作。
| 組合 | 什麼時候用 |
|---|---|
| 125B+生圖+STT+TTS+嵌入 | 日常,相當於本地版 GPT,能語音溝通、看圖、生圖、寫程式、自動化 |
| 35B+生圖+STT+TTS+嵌入 | 大量多媒體創作,把 125B 換成 35B 讓出空間 |
| 單一 125B | 只做文字工作 |
另外還有兩個小數字。GB10 上 STT 加逐字對時最高約 6.8GB,不對時約 5.1GB。Mac 上 GPT-SoVITS 載入約 2.8GiB、峰值 4.1GiB。這些加起來就是你「常駐服務」的底價。
Mac 要留意一件事。macOS 預設只把約七成五的記憶體給 GPU,我的 128GB 實測是 107.5GiB。64GB 的機器 GPU 實際只分到約 51GB,跑大模型要手動放寬上限,重新開機會恢復原狀。
我自己做了一個主控台管這些模型,每個模型開了沒、佔多少記憶體、剩多少都一眼看到,記憶體不夠時會擋住不讓啟動。你不用自己從頭寫,把這一段需求丟給你的 AI,讓它幫你做就行。
MacBook 和 GB10 到底差在哪?
我本來以為頻寬大就是一切,實測後發現不是。兩台都是 128GB,GB10 頻寬 273GB/s,MacBook M5 Max 約 614GB/s。
| 項目 | GB10 | MacBook M5 Max |
|---|---|---|
| Qwen 3.8 大腦生成 | 較慢 | 約 1.8 倍快 |
| 生圖(1888×1056) | 一張 29 秒 | 一張 61 秒 |
| 語音轉文字 | 7.7 秒語音 0.68 秒轉完 | 5 秒語音要 1 秒 |
| GPT-SoVITS 講 1 秒的話 | 算 0.13 秒 | 算 0.27 秒 |
| IndexTTS-2 講 1 秒的話 | 算 0.38 秒 | 約 1.5 秒 |
文字生成 Mac 快,其他幾乎都是 GB10 快兩到四倍。macOS 升到 27.2 之後情況更糟,PyTorch 的半精度會算錯,語音模型開半精度會轉出空白或唸成重複字,我只好改用全精度,速度又慢了一些。
不過 Mac 有不少加速空間。生圖換成 int8 格式的模型,一張從 61 秒降到 41 秒;STT 換成 Mac 專用的 MLX 版,我把 TEA-ASR 轉成 MLX 8bit 後,6.5 秒的語音約 0.2 秒就轉完。這些我還在測,有新數字再補。
所以我的結論是,只做文字對話,Mac 很划算;常要生圖、做語音、做影片,CUDA 機器比較順。你要看自己的工作比重。
預算有限,不是 128GB 怎麼辦?
不是人人都需要 128GB。下面是我整理的 Mac 各檔記憶體能跑什麼,整理自別人的機型評比影片再加上我的體驗,其中我沒入手的機型數字僅供參考。PC 的做法不同,主要看顯示卡的顯存,原則一樣是模型要放得進去。
| 記憶體 | 適合的模型 | 我的備註 |
|---|---|---|
| 16GB | 9B 到 14B 的小模型 | 系統先用掉三四 GB,實際可用約 12 到 13GB,聊天、翻譯、寫東西夠用 |
| 24GB | 27B 到 30B 的 Q4 | 從勉強能用變成用起來順手 |
| 32GB | 35B 的 Q4 | 個人入門選擇,寫作、補程式碼都能離線做 |
| 48GB | 35B 的 Q5、Q6,70B 的 Q4 | 70B 到這檔才穩 |
| 64GB | 70B 的 Q4、Q5 | CP 值最高的一格,120B 勉強能上 |
| 128GB | Qwen 3.8 125B 這類大模型 | 我的主力配置 |
估算模型大小有個簡單換算。Q8 大約每 10 億參數佔 1GB,Q4 再少一半,所以 70B 的 Q4 約 40GB。我沒有把 27B 與 35B 的各量化版逐一量過,表格裡的數字請當估算用。
如果你想用最小預算先入門,8GB 顯存的一般顯卡就能跑 9B 左右的模型,做工具調用和基礎聊天,可以先看 LM Studio 本機模型實測攻略。想買 Mac 的話,我另外整理了各預算怎麼挑,之後會有專文。
我自己買 Mac 都直接挑頂配,因為記憶體焊在晶片上,買完就不能再加。記憶體價格近期也一直在漲,這點下單前要先算進去。
還有哪些模型我測過但沒有常駐?
有些模型我測完之後沒有放進日常配置,分享給你參考。
| 模型 | 我的實測 | 為什麼沒常駐 |
|---|---|---|
| Nemotron 3.5 Super 120B(NVFP4) | 生成 16 到 64 token/秒,長輸出約 47 到 54;讀取 635 到 3450 token/秒;100K 上下文首字約 61 秒;權重約 70GiB | 我用同一組題目測,整體輸給 125B |
| Nemotron 3.5 Bolt 74B(2 bit) | 程序約 29GiB,能看圖也能看影片 | 落地頁、遊戲初版與除錯這三題不合格,數據題最準 |
| DeepSeek V4 Flash(IQ2_XXS) | 在 Mac 上生成 36 token/秒,峰值 98GB | 三題只有一題合格,品質輸給我現用的兩顆,已移除 |
這些測試的題目是落地頁、生存遊戲和 3D 跑酷這類我自己出的題,不代表通用排名。你換成自己的工作去測,結果可能不同。
從哪裡開始?照這五步做
- 先想清楚你為什麼想要一個完全自由的地端 AI,用途決定你要多大的記憶體。
- 挑一台你心儀的 128GB 機器,預算有限就先把錢放在記憶體容量。
- 先挑一個大腦。要萬用選 125B,寫程式選 27B,要快選 35B。
- 裝好語音轉文字,試著用講的跟 AI 交代一件事。
- 把一個資料夾的筆記丟進向量資料庫,問它一個只有你知道答案的問題。
第一次聽到 Agent 用你自己的資料回答你,你就會懂我為什麼堅持要有一台地端機器。這套配置不用照抄,照你的使用情境調整就好。
把這台機器變成你的 AI Agent
硬體只是起點。有了機器和模型之後,怎麼讓它接上工具、記住你的事、自己把工作做完,才是 Agent 真正的價值。我把這一套整理成 AI Agent 自學網的課程,L0 和 L1 都能免費開始,你可以從頁面底下的連結直接進去。
常見問題 FAQ
地端 AI 是什麼?
地端 AI 就是把開源大模型裝在自己的電腦上跑,資料不用上傳雲端,斷網也能用。我用它當 AI Agent 的大腦,再搭配語音轉文字、語音合成、向量資料庫和生圖模型,組成一個能對話、能做事的私人助手。
跑地端 AI 要準備多少記憶體?
要跑到 125B 這個等級的大腦,又想同時開語音和生圖,我的答案是 128GB 統一記憶體。我實測 125B 的 3 bit 版約佔 58GB,再同時開語音、嵌入與 ComfyUI 生圖,一台 128GB 就成了會聽、會說、會看圖、會生圖的多模態 AI Agent。預算有限的話,64GB 能跑 70B 的 Q4,32GB 能跑 35B 的 Q4,只是不能同時開那麼多服務。
地端 AI 的大腦要選哪個模型?
看你最常做什麼。要萬用選 Qwen 3.8 125B,寫程式選 Qwen3.8 27B,要回話快選 occamy 1.0 35B。我平常常駐一個,工作型態換了再換模型,不需要三個同時開。
MacBook 和 GB10 哪個適合跑地端 AI?
兩台都是 128GB。我實測同一顆 125B 大腦,MacBook M5 Max 生成速度快將近一倍,但生圖、語音轉文字、語音合成都是 GB10 快兩到四倍。只跑文字對話選 Mac 划算,要同時做多媒體,GB10 這類 CUDA 機器比較順。
沒有 128GB 的電腦還能跑地端 AI 嗎?
可以,只是模型要選小一點。16GB 能用 9B 到 14B 的小模型做聊天、翻譯和寫作,24GB 到 32GB 能上 27B 到 35B 的 Q4。這篇的模型清單都能照記憶體大小挑小一級的量化版,原則一樣。