Article
Mac 跑本地 AI 要買哪台?16G 到 512G 每檔能跑多大模型,照預算挑的懶人包
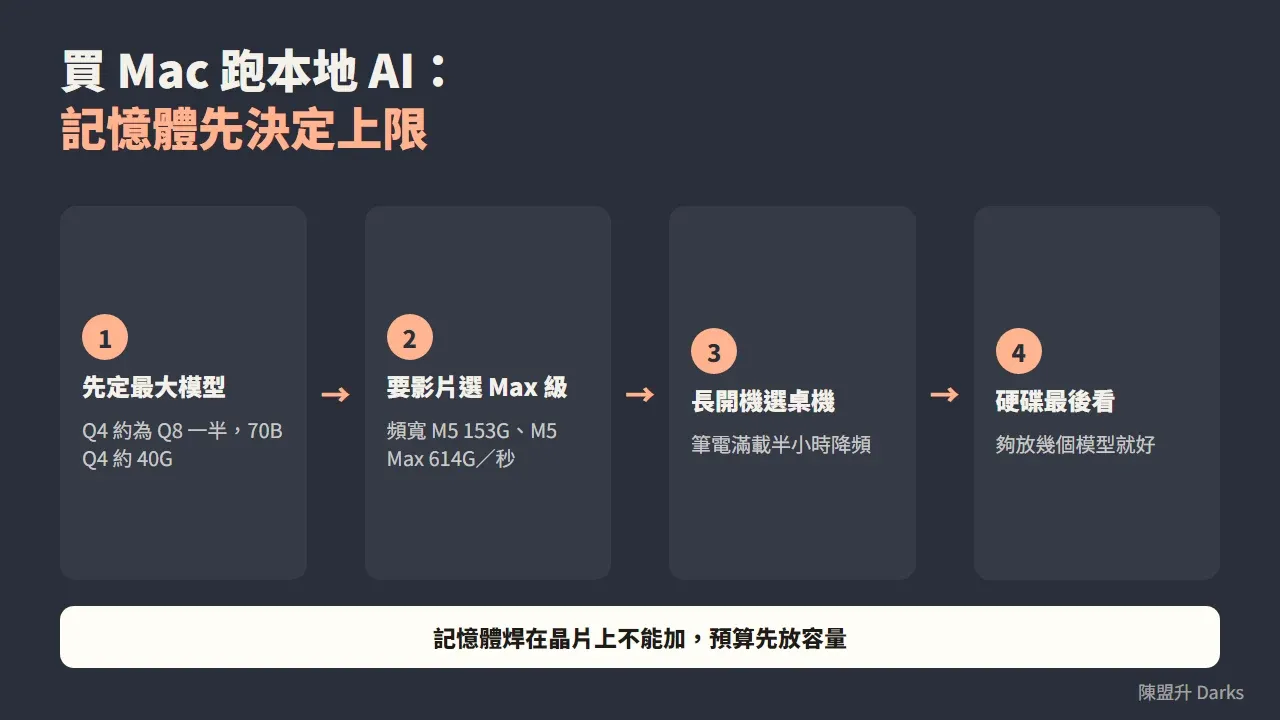
Mac 跑本地 AI 要買哪台,先看統一記憶體容量,再看記憶體頻寬,最後才輪到硬碟。只要是 M 系列晶片的 Mac 都能跑本地大模型,但模型必須整個放進記憶體,所以下單選的容量就是上限。我自己用 128G 的 MacBook Pro M5 Max 實測,Mac 跑 125B 等級的模型每秒可以生成 82 到 93 個 token。以下用記憶體檔位對照,你照預算挑。
這篇的選購框架整理自「单车酒吧搞機社」的影片,我先在 Facebook 分享過,那篇有 143 個讚、45 次分享。選購的數字和表格以原作者的內容為準,Apple 台灣官網的價格是我 2026 年 11 月 4 日查的。後半段是我自己 128G 機器的實測,數字都是我在機器上量出來的。
想知道本地 AI 整體要怎麼從零開始架,可以先看地端 AI 總整理。如果還在猶豫該用雲端還是本地,看雲端 AI 和地端 AI 怎麼選。
Mac 跑本地 LLM,為什麼只要是 M 系列就行?
判斷一台 Mac 能不能跑大模型很簡單,確認它是 M 系列晶片就可以。
Mac 跟 PC 的做法不一樣。PC 主要靠顯示卡,顯示卡記憶體不夠就換卡或加卡。Mac 沒有獨立的顯示卡記憶體,CPU、GPU 和系統共用同一塊統一記憶體。
這塊記憶體直接焊在晶片上,買完就沒辦法再加。所以下單選的記憶體,就是這台 Mac 能跑多大模型的上限。我自己的兩台都直接挑頂配,原因就在這裡,之後有錢也沒法擴充。
頂配價格不便宜。好消息是 Mac 現在可以多機串連,你可以先買適合現階段的機型。
三個規格裡,哪個最重要?
挑 Mac 跑 AI 有三個規格,重要程度差很多。
| 規格 | 決定什麼 | 優先順序 |
|---|---|---|
| 記憶體容量 | 能裝多大的模型 | 第一 |
| 記憶體頻寬 | 跑多快 | 第二 |
| 硬碟 | 只存模型和檔案,跑模型時用不到 | 最後 |
記憶體容量排第一,是因為模型必須整個塞進記憶體才會正常運作。塞不進去就直接載入失敗。
PC 顯示卡記憶體不夠時,會借用電腦的記憶體,變慢但還能用。Mac 塞不下會改用硬碟當虛擬記憶體,生成速度從每秒 20 幾個 token 直接掉到零點幾,整台卡住。
所以挑 Mac 要先算容量夠不夠。你也可以先列出自己最想跑的那個模型,再回頭看需要多少記憶體。
Q4、Q5、Q6、Q8 是什麼?模型大小怎麼估?
看記憶體對照表之前,先搞懂量化。Q4、Q5、Q6、Q8 是模型壓縮的程度,數字代表每個參數用幾位元存,越大越接近原版,也越佔空間。
| 量化 | 品質 | 大小 |
|---|---|---|
| Q8 | 跟原版幾乎一樣,一般當成原廠品質 | 約原版一半 |
| Q6 | 跟 Q8 很接近,日常使用很難分出差別 | 比 Q8 小 |
| Q5 | 比 Q6 再省一點空間,品質掉一點點 | 再小一點 |
| Q4 | 最常見的折衷,大模型用 Q4 通常還很好用 | 約原版四分之一 |
有一個好記的換算。Q8 大約每 1B 參數佔 1G,Q4 大約再少一半。70B 的 Q4 大約 40G,你要估自己需要多大的記憶體時,直接套這個算法。
這個換算同樣適用其他模型。你想跑的不管是哪一顆,只要查到參數量,就能先估出要多少記憶體。
16G 到 512G,每一檔能跑什麼?
這張表是這篇的重點。我分成個人日常用的 16G 到 48G,以及能跑大模型的 64G 以上。
| 記憶體 | 常見機型 | 能跑的模型 | 適合誰 |
|---|---|---|---|
| 16G | MacBook Air、Mac mini 入門款 | 9B 到 14B 小模型,8B Q4 每秒約 15 到 25 個 token;20B 放得進去但幾乎滿載 | 聊天、翻譯、寫東西 |
| 24G | Mac mini 等 | 27B 到 30B 的 Q4 | 想讓本地 AI 從勉強能用變順手 |
| 32G | 個人入門選擇 | 35B Q4 放得下 | 寫作、補程式碼、翻譯,離線使用 |
| 48G | 較高階筆電 | 35B 可上 Q5、Q6,回答更精準;70B Q4 約 30 到 40G,到這檔才穩 | 要更精準的回答 |
| 64G | Mac mini M5 Pro、Mac Studio | 70B 的 Q4、Q5 跑得順,120B 勉強能上,開始能跑本地影片生成(還要看頻寬) | CP 值最高的一格 |
| 96G | Mac Studio | 120B 等級的模型到這檔才順 | 要跑大模型的人 |
| 128G | MacBook Pro、Mac Studio | 千問 3.8 這類大模型已到可用的程度 | 認真把 Mac 當 AI 主機 |
| 256G、512G | Mac Studio 頂配 | 300 多 B、400 多 B 的模型用 FP4 單機就能跑;512G 連 671B 的 Q4(整個模型約 400G)都放得下 | 做到一般顯示卡做不到的事 |
16G 為什麼只有 12 到 13G 能用?系統先用掉三、四 G,macOS 預設又只把約七成五的記憶體給 GPU,所以實際能用的比標示少很多。
64G 是整張表最值得注意的一格。70B 的 Q4、Q5 能跑得順,120B 勉強能上,價格又沒有直接跳到 Mac Studio 頂配的等級。
去年要跑 671B 這種規模的模型,得用十張 A100 80G 顯示卡。現在一台 Mac 就能做到,安安靜靜、耗電不到 200 瓦。
同一個模型,在哪顆晶片上比較快?
放得下之後,接著看跑多快,這由記憶體頻寬決定。原作者給了一個很好記的算法,生成速度上限大約等於記憶體頻寬除以模型大小。
舉例,8B 模型壓到 4 位元大約 4G。放在 M5(頻寬每秒 153G),理論上限每秒約 30 多個 token。放在 M5 Max(頻寬每秒 614G),理論上限每秒約 150 個 token。同一個模型,速度差了四倍。實際大約能跑到理論值的五到八成。
| 晶片 | 記憶體頻寬 |
|---|---|
| M5 | 153G/秒 |
| M5 Pro | 307G/秒 |
| M5 Max | 614G/秒 |
| M5 Ultra | 1228G/秒 |
想跑本地影片生成,頻寬至少要到 Max 等級,太低會跑很慢。
Mac 買哪個機型?Mac mini、MacBook 還是 Mac Studio?
同樣的記憶體,不同機型價差很大。以下是我 2026 年 11 月 4 日在 Apple 台灣官網查到的售價。
| 機型 | 記憶體 | 售價 |
|---|---|---|
| Mac mini M6 | 16G 起,最多加到 32G | NT$29,900 起(32G 為 NT$43,900) |
| Mac mini M5 Pro | 24G 起,加到 64G | NT$59,900 起(64G 為 NT$94,900,再升 18 核 CPU 為 NT$101,900) |
| Mac Studio M5 Max 入門款 | 36G | NT$84,900 |
| Mac Studio M5 Max 上 64G | 要選 40 核 GPU 版 | NT$119,900 |
| Mac Studio M5 Ultra | 96G 起,最多 512G | NT$199,900 起(512G 為 NT$787,900) |
我 2026 年 11 月再用 Apple 台灣官網的購買頁核對過機型和記憶體組合,Mac mini 的 M6 與 M5 Pro、Mac Studio 的 M5 Max 與 M5 Ultra 都對得上。價格頁面當下沒顯示金額,我另外對了台灣媒體報導,Mac mini M6 的 NT$29,900 起、M5 Pro 的 NT$59,900 起,Mac Studio M5 Max 的 NT$84,900 起、M5 Ultra 的 NT$199,900 起,都和我 11 月 4 日記下的一致。更高階配置的金額,請你下單前再到官網確認。
同樣 64G,Mac Studio 比 Mac mini 貴 NT$25,000,多出來的錢沒有多給記憶體,花在頻寬和散熱上。
筆電有另一個要注意的地方。原作者提醒,筆電滿載跑半小時左右會降頻,同一顆晶片在 MacBook 和 Mac Studio 的長時間表現不一樣。我自己的 MacBook Pro M5 Max 在 125B 等級模型的連續測速裡,GPU 一般約 78°C、最重 93°C,系統沒有跳出降頻警告,但我沒有測到更長時間的滿載。要長時間開著跑模型,桌機會穩很多。
我的筆電是為了斷網能帶著走才買的。沒有這個需求,直接選能放家裡的就行,反正 AI 模型都是遠距連線的。
下單前,macOS 的 GPU 記憶體上限要先知道
macOS 預設只把部分記憶體給 GPU 用。依原作者的說法是約七成五,買 64G 的機器,GPU 實際只分到約 51G。
跑大模型時要手動下一行指令放寬上限,但重新開機就會恢復原狀。
我自己的 128G MacBook Pro M5 Max,預設能給 GPU 的上限實測是 107.5 GiB。我後來在自己的主控台放了一個按鈕,點一下把上限提高到 116 GiB,再點一次恢復,重開機也會恢復。要不要提高,看你要跑多大的上下文。
我的 128G M5 Max 實測,到底跑得多快?
前面是選購框架,這段是我自己機器的實測。我平常用一台 GB10 當地端伺服器,之後又加了一台 MacBook Pro M5 Max 128GB,所以拿同一顆模型兩邊對比過。測試用的都是社群大神們做的無審查版本,目的是把它當我 AI Agent 的大腦,上下文開到約 26 萬。
| 測試 | 量化 | 生成速度 | 記憶體 |
|---|---|---|---|
| 125B 等級模型,Strata 引擎 | 3 bit(Swift 1.5) | 每秒 82 到 93 個 token | 約 78GB |
| 同一顆,oMLX 引擎 | 5.7 bit(oQ5e,128G 放得下的最大版本) | 每秒 61 到 92 個 token | 最高約 94GB |
| 4 bit 無審查版,mlx-serve | 4 bit(ARC4NUM) | 短題每秒約 80.5,26.2 萬上下文約 55.5 | 常駐 71.7GiB,26.2 萬時峰值 86.9GiB |
同一顆 3 bit 的模型,放在我的 GB10 上每秒是 43 到 50 個 token,Mac 快了將近一倍。代價是長文讀得比較慢,讀 6.4 萬 token 在 GB10 約 30 秒,在 Mac 約 45 秒。
後來我實測 oQ5e 在乾淨環境下把上下文開到 26.1 萬,記憶體峰值約 111.8GB,GPU 上限在那次測試調到 116GB,勉強過關。所以 128G 要開滿上下文,要先把 GPU 上限調高,同時不要再開別的大程式。
讀過的對話我還讓它存進硬碟快取。我實際聊到 8.9 萬 token,第一句讀 56 秒,下一句只要 0.75 秒就開始回。這讓 Mac 載入慢的缺點小了很多。
3 bit 和 5.7 bit 該怎麼選?
兩顆我都留在 Mac 上,看要做什麼再切換。
- 想回得快,或 Mac 還要跑生圖之類的工作,我切 3 bit。
- 想要品質高,我用 5.7 bit。
品質差異我在 AI Agent 叫工具時看得最清楚。最初沒設定好,Agent 叫工具一直被退回,3 bit 會直接卡住,以為自己做完了。5.7 bit 能發現自己的工具有問題,轉而向我回報並要求協助。
4 bit 的 ARC4NUM 速度最快,我讓它做網頁和小遊戲各三題,每題 1.5 到 2 分鐘,比兩顆大的快很多。但品質比較差,兩個遊戲都出現敵人打不死的問題,所以我目前沒拿它當主力。
這些只是我個人的使用情境,只測了我自己的這幾顆模型。同樣是 128G,你要跑的模型不同,結果也會不同。
照這四步,依預算和需求挑 Mac
- 先決定你要跑的最大模型,用上面那張表定出記憶體容量。
- 再決定要不要跑本地影片生成,要的話頻寬至少選 Max 等級。
- 會長時間跑模型,優先挑 Mac mini 或 Mac Studio,筆電留給要帶著走的人。
- 硬碟最後看,夠放你要的幾個模型就好。
預算有限,先把錢放在記憶體容量。預算比較寬,再加錢換頻寬和散熱。
另外,原作者提到記憶體價格已經漲到前所未見的程度,蘋果執行長在財報會議上說這一季還會漲,明年也會繼續漲。想買的話,我會早點決定,別拖到明年。
買好 Mac 之後,用什麼軟體跑模型?
在 Mac 上跑本地 LLM,我最常用的是 LM Studio 和 Ollama 這類工具,它們都能在 Mac 上直接用。
- LM Studio 有圖形介面,挑模型、下載、對話都在視窗裡,新手好上手。我的實測步驟寫在LM Studio 本機未審查模型與專屬知識庫的實測攻略。
- Ollama 用指令列,適合要接進程式或 AI Agent 的人。
- 我自己追求速度和較大的模型,會用 Mac 專用的引擎,像前面實測用的 oMLX 和 Strata,這部分需要多花一點時間設定。
我現在把 Mac 當成 AI Agent 的離線大腦,目標是不連網也能跑。這件事牽涉的是 Agent 怎麼用本地模型,我在自學網的免費課有講。
先挑好機器,再讓本地 AI 為你做事
Mac 選好只是第一步。模型跑起來之後,真正有價值的是讓它替你做事,而不只是聊天。這類情境很通用,不管你買的是 16G 還是 512G,都可以把本地模型接成自己的 AI Agent。
你可以先看地端 AI 總整理了解整體架構,再決定你的 Mac 要扮演哪個角色。
希望大家都能挑到適合自己的機器,讓本地 AI 為自己所用。
原作者是「单车酒吧搞机社」,內容整理自他的影片,影片在中國的平台上,這裡不附連結。有興趣的話,可以直接搜尋他的名字看其他硬體影片。
常見問題 FAQ
Mac 跑本地 LLM 最重要的規格是什麼?
記憶體容量最優先。Mac 的 CPU、GPU 共用同一塊統一記憶體,模型必須整個放得進去才能正常運作,放不進去會直接載入失敗,或改用硬碟當虛擬記憶體,速度掉到每秒不到 1 個 token。其次看記憶體頻寬,它決定跑多快,硬碟容量只管存檔。
16G 的 Mac mini 或 MacBook Air 能跑本地 AI 嗎?
可以,但只適合 9B 到 14B 的小模型。系統會先用掉三、四 G,GPU 預設只能用約七成五,實際可用約 12 到 13G。8B 模型 Q4 量化每秒大約 15 到 25 個 token,聊天、翻譯、寫東西夠用,20B 放得進去但幾乎滿載。
Mac 跑本地模型要買 MacBook 還是 Mac mini、Mac Studio?
要長時間開著跑模型,優先選 Mac mini 或 Mac Studio,筆電滿載跑半小時左右可能降頻。需要斷網帶著走再選筆電。我自己的 MacBook Pro M5 Max 是為了離線攜帶才買,沒有這個需求的話,放家裡的機器比較省心。
Mac 買了之後可以加記憶體嗎?
不行。統一記憶體直接焊在晶片上,下單時選的容量就是這台 Mac 能跑多大模型的上限。預算有限時,先把錢放在記憶體容量,預算寬裕再加錢換頻寬和散熱。
Mac 上要用 LM Studio 還是 Ollama?
兩個都能在 Mac 上跑本地模型。LM Studio 有圖形介面,挑模型、下載、對話都在視窗裡完成,新手比較好上手。Ollama 用指令列,適合要接進程式或 AI Agent 的人。要不要用無審查模型、怎麼設定,我另外寫過 LM Studio 的實測文章。
128G 的 Mac 能跑多大的模型?
我自己的 MacBook Pro M5 Max 128G 實測,125B 等級模型的 3 bit 版記憶體約 78GB,生成每秒 82 到 93 個 token。換成 5.7 bit 的 oQ5e 版,記憶體最高約 94GB,每秒 61 到 92 個 token。這是 128G 放得下的最大版本。