Article
DGX Spark(GB10)vs MacBook M5 Max:同一顆模型跑本地 AI Agent,誰比較快?
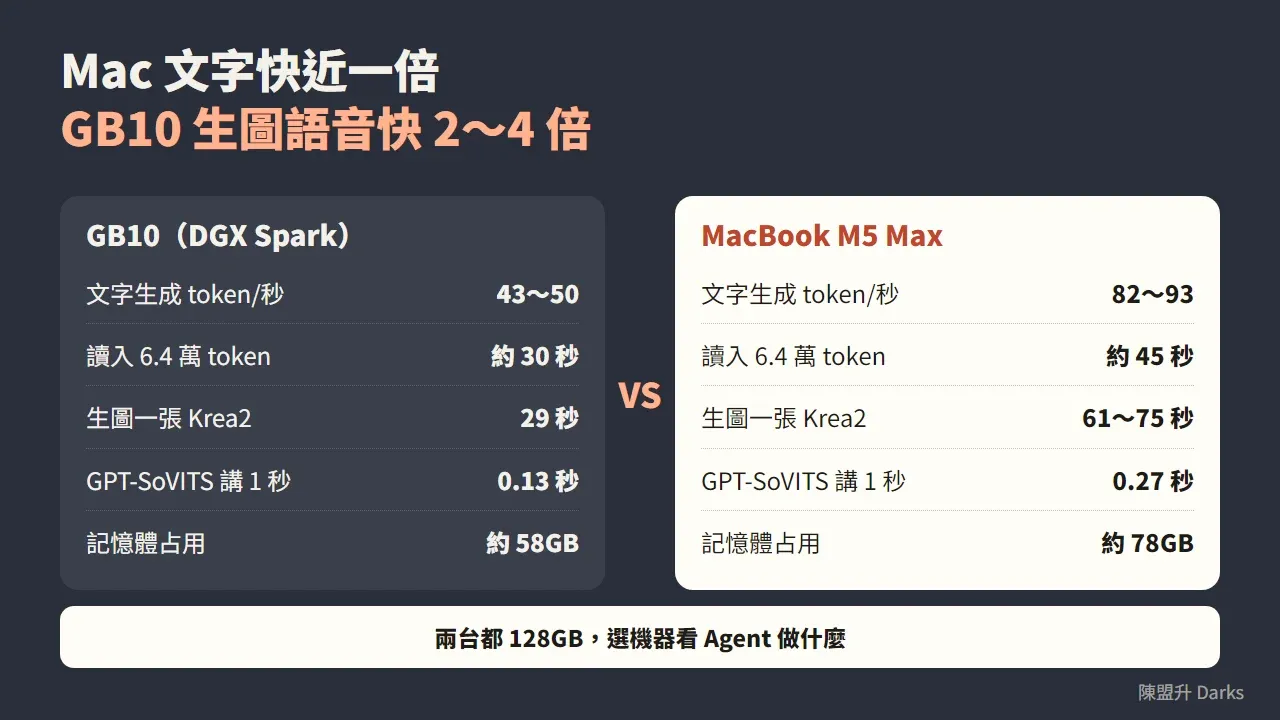
同一顆 Qwen3.8-Flash-Next 3 bit 模型,我實測 M5 Max 128GB 文字生成每秒約 82~93 個 token,GB10(DGX Spark 用的晶片)約 43~50 個,Mac 快將近一倍。生圖和語音工具則是 GB10 快兩到四倍。兩台都是 128GB,選機器看 Agent 做什麼。
這篇是我自己在兩台機器上量出來的數字。兩台我都拿來當 AI Agent 的大腦,所以特別關心「同一個模型、同樣的參數」誰比較快、誰比較省記憶體。如果你正在查 gb10 vs m5 max、dgx spark 跑大模型,下面直接看數字。
GB10 和 M5 Max 的規格差在哪?
兩台都是 128GB 統一記憶體,但頻寬差很多。
| 項目 | GB10(DGX Spark) | MacBook Pro M5 Max |
|---|---|---|
| 記憶體 | 128GB LPDDR5x 統一記憶體 | 最高 128GB 統一記憶體 |
| 記憶體頻寬 | 273 GB/s | 最高 614 GB/s(40 核 GPU 版本) |
| 我的機器 | 128GB | 128GB,8TB 硬碟 |
規格來源是 NVIDIA 官方 DGX Spark 頁面與 Apple 官方發表新聞稿。Apple 的規格表另外寫了 M5 Max 搭 32 核 GPU 是 460 GB/s,614 GB/s 只有 40 核 GPU 版本才有,要買 128GB 也只能選 40 核那一版。
Mac 的頻寬約是 GB10 的 2.25 倍。我原本以為頻寬大就是一切,後面的數字會讓你看到實際狀況。
同一顆模型跑本地 AI Agent,誰的文字生成比較快?
文字生成是 Mac 贏。我用 Strata 引擎跑 Qwen3.8-Flash-Next 的 Swift 1.5 無審查 3 bit 版(這類無審查模型是開源社群的大神們製作的),上下文開到 262K,兩台參數照同一份設定。
| 項目 | GB10 | MacBook M5 Max |
|---|---|---|
| 生成速度 | 每秒 43~50 token | 每秒 82~93 token |
| 讀入 6.4 萬 token | 約 30 秒 | 約 45 秒 |
| 讀入 23 萬字 | 約 123 秒 | 約 170 秒 |
| 同時 4 段 | 26.6 秒 | 16.6 秒 |
| 記憶體占用 | 約 58GB | 約 78GB |
生成速度 Mac 快約 1.8 倍,同時跑 4 段請求也是 Mac 快。讀很長的文章時反過來,GB10 比較快,因為讀入吃的是運算力,不只是頻寬。
我的 AI Agent 優化過,快取命中率有 93%,長文只有第一次載入慢,之後持續對話很快,所以讀入慢在日常使用上影響不大。Mac 在我這邊的邊界要先講清楚,這些數字是 Strata 引擎加這顆模型的結果,換引擎或換模型會不一樣。
128GB 的 Mac 最多能塞多大的量化?
Mac 能塞的量化比我預期大。除了 3 bit,我另外找到 oMLX 版的 Orca 無審查模型,5.7 bit,是 128GB 的 Mac 放得下的最大版本。位元越高越接近原版模型。
| 項目 | Swift 3 bit | Orca 5.7 bit(oMLX) |
|---|---|---|
| 生成速度 | 每秒 82~93 token | 每秒 61~92 token |
| 讀入 6.4 萬 token | 約 45 秒 | 約 39 秒 |
| 記憶體峰值 | 約 78GB | 最高約 94GB |
兩顆我都留在 Mac 上。要快、或需要同時生圖,就切 3 bit;不需要生圖,就用 5.7 bit 追求更聰明的版本。
品質差在哪我也看到了。最初設定沒調好時,我的 AI Agent 用 Mac 上的 3 bit 叫工具,一直被退回,3 bit 會卡住,以為自己做完了;5.7 bit 能發現自己的工具有問題,轉過來向我回報並請我協助。
oMLX 還會把讀過的對話存進硬碟快取。我實際聊到 8.9 萬 token,第一句讀了 56 秒,下一句只花 0.75 秒就開始回,切換 Agent 對話後也能快速接回來,補上了 Mac 載入慢的缺點。
上下文開到 26 萬,記憶體會不會爆?
我另外量過極限。乾淨環境、GPU 上限調到 116GB,5.7 bit 的 oMLX 版上下文開到 26.1 萬 token 也跑得過,記憶體峰值最高約 111.8GB,離上限只剩約 4GB。
Mac 的 GPU 預設只能用約四分之三的記憶體(128GB 機型約 107.5 GiB)。我早上有一次 16.8 萬就爆了,原因是當時上限設 107.5GB,而且 ComfyUI 同時開著。所以在 Mac 上跑滿上下文時,其他吃記憶體的程式要先關。
生圖、語音這些工具,GB10 為什麼快很多?
我的 AI Agent 是多模態的,除了文字,還會生圖、聽、說。我把原本跑在 GB10 的工具搬到 MacBook,用同一個模型、同樣的參數量了一次。
| 項目 | GB10 | MacBook M5 Max |
|---|---|---|
| 生圖 1888×1056(Krea2) | 一張 29 秒 | 一張 61~75 秒 |
| 語音轉文字 | 7.7 秒語音 0.68 秒轉完 | 5 秒語音要 1 秒 |
| 文字轉語音 GPT-SoVITS | 講 1 秒算 0.13 秒 | 講 1 秒算 0.27 秒 |
| 文字轉語音 IndexTTS-2 | 講 1 秒算 0.38 秒 | 講 1 秒算約 1.5 秒 |
文字模型 Mac 快 1.8 倍,但這四項都是 GB10 快兩到四倍。差距來自這些工具大多為 NVIDIA 的 CUDA 寫的,在 Mac 上要走 MPS 路線,沒有針對 Apple 晶片最佳化。
生圖在 Mac 上還有溫度問題。我連續生圖時發現會越跑越慢,GPU 到 96~97°C、頻率掉了約 21%,原因查出來是過熱,記憶體並沒有不夠。
macOS 升級後,半精度語音模型出錯怎麼辦?
我把 MacBook 升級到 macOS 27.2 之後,情況更糟。PyTorch 在 Mac 的 MPS 上開半精度,語音轉文字會轉出空白,文字轉語音會唸成重複的字。我只能改用全精度,速度又比前兩天慢了一些。
後來我查出病根在 PyTorch MPS 的 scaled_dot_product_attention(is_causal=True),半精度會算錯,改傳明確的遮罩就對。但最省事的做法是換成 Mac 專用的 MLX 版,下一段有數字。
換成 Mac 專用的 MLX 版,速度能追回多少?
追回很多。我花了一輪把語音換成 MLX 版,實測結果如下。
| 項目 | 改前(PyTorch) | 改後(MLX) |
|---|---|---|
| 語音轉文字(6.5 秒語音) | 0.67 秒 | 0.21 秒,錯字率 1.0% 降到 0.6%,顯存 14.6 降到 5.6GiB |
| IndexTTS(MLX 2.0 原聲線 8bit) | RTF 1.44 | RTF 0.52,顯存 40 降到 14GiB |
| IndexTTS(MLX 2.5 int8) | RTF 1.44 | RTF 0.30,顯存約 8GiB,但沒有情緒控制 |
用同一批句子,經網路量 GB10 開著的服務,語音轉文字 Mac 0.18 秒、GB10 0.62 秒,Mac 快 3.4 倍。GPT-SoVITS 則 GB10 還是快,0.14 對 0.26 秒,快 1.8 倍。
生圖加速我也試了。換成 int8 格式的模型並裝上 Apple 晶片的加速套件,一張從 61 秒降到 41 秒。我平常用的那顆模型 int8 版我還沒測,這是我接下來要測的。
這代表一件事。同樣的硬體,換成對的軟體,差距能明顯縮小,語音轉文字甚至反超。GB10 的優勢是用 CUDA 生態的工具不用改就能跑;Mac 的優勢是肯花時間換 MLX 版就能追上。
我的建議:DGX Spark 用途與 Mac 該怎麼分工?
我自己的分工是這樣。
| 你的需求 | 我的選擇 | 理由(來自上面的實測) |
|---|---|---|
| 主要是文字模型當 AI Agent 大腦 | Mac | 生成約快 1.8 倍,5.7 bit 也塞得下 |
| 要同時開生圖、生音樂、生影片的 ComfyUI | GB10 | Krea2 一張 29 秒對 61~75 秒 |
| 用現成 CUDA 工具不想改 | GB10 | 語音、生圖不用換版本就快 |
| 要攜帶、斷網單機運作 | Mac | 筆電形態,我時隔 4 個月再開機電力只從 80% 降到 61% |
| 常駐伺服器同時開多個服務 | GB10 | 3 bit 模型只占 58GB,剩下的記憶體可開語音、嵌入與 ComfyUI |
GB10 這台我拿來當常駐伺服器。Swift 3 bit 只占 58GB,剩下的記憶體剛好夠我同時開語音轉文字、文字轉語音、做資料庫查詢的嵌入模型,還有 ComfyUI。dgx spark 用途對我來說就是這樣,一台機器同時撐起一整套 AI Agent 的多模態工具。
Mac 則是我把它做成可以斷網單機運作的 AI Agent 設備,資料要和常駐在 Linux Docker 資料庫的 AI Agent 同步,這部分是我最近兩週的目標。
如果你想搭配本機模型的挑選與安裝,可以先看 我的地端 AI 環境建置指南;打算買 Mac 當地端主力的人,可以看 Mac 本地 LLM 選購指南。大模型的另一條路線,我實測過 自架無審查 DeepSeek V4 Flash 與 128GB 顯存需求,可以和這篇對照著看。
這份實測的邊界和我還沒測的
幾個我自己要先講清楚的限制。
- GB10 的規格數字我引用 NVIDIA 官方對 DGX Spark 的標示,實測是在我自己的 GB10 機器上做的。
- Mac 我只測了 MacBook Pro M5 Max 128GB,沒有測 Mac Studio,所以 gb10 mac studio 這組對照我沒有自己的數字。
- 所有速度都是我在這兩台機器上、當時的軟體版本與 macOS 27.2 底下量的,換引擎、換版本結果會變,我之後有新數據會再更新。
- 還沒測的有三項:生圖加速套件配我平常用的模型的 int8 版、Mac 專用 MLX 版的台灣中文特化語音轉文字(目前別人公布的只有通用版)、等 Apple 修好半精度之後的語音速度。
不管你選哪一台,我的做法是先決定你的 AI Agent 要跑哪些工具,再回頭選機器。想從零做出自己的 AI Agent,可以從 什麼是 AI Agent 開始讀,看你手邊的機器能撐到哪裡。
開始用你手邊的機器,做出自己的地端 AI Agent
想知道怎麼把模型、工具和記憶串成一個真的能用的 AI Agent,我把入門流程整理在 AI Agent 自學網,L0、L1 都是免費的。你不用先買機器,先用現有的電腦走完一遍,就知道自己缺的是算力還是記憶體。
常見問題 FAQ
DGX Spark 跑大模型,文字生成會比 MacBook M5 Max 快嗎?
以我實測的同一顆 Qwen3.8-Flash-Next 3 bit 模型來看,文字生成是 MacBook M5 Max 比較快。GB10 每秒約 43~50 個 token,M5 Max 每秒約 82~93 個,約快一倍。讀入很長的文章時反而是 GB10 比較快,23 萬字 GB10 約 123 秒,Mac 約 170 秒。
DGX Spark 用途適合做什麼?
以我的使用方式,GB10 適合當常駐伺服器,同時開文字模型、語音轉文字、文字轉語音、嵌入模型和 ComfyUI。它的 CUDA 生態讓生圖、語音這類工具不用改寫就能直接跑,而且速度比我的 Mac 快兩到四倍(改用 Mac 專用 MLX 版的語音除外)。
GB10 和 M5 Max 的記憶體規格差在哪?
兩台都是 128GB 統一記憶體。NVIDIA 官方標示 DGX Spark 為 128GB LPDDR5x、頻寬 273 GB/s;Apple 官方標示 M5 Max 最高 128GB、頻寬最高 614 GB/s(40 核 GPU 版本)。
記憶體頻寬比較大,AI 就一定比較快嗎?
不一定。我的實測裡 Mac 頻寬約是 GB10 的 2.25 倍,文字生成確實快,但生圖、語音轉文字、文字轉語音在同樣的 PyTorch 工具下都是 GB10 快兩到四倍。這些工作吃的是運算和軟體生態,頻寬大不代表全都比較快。
128GB 的 MacBook 能跑多大的本地模型?
我實測 Mac 能跑 Qwen3.8-Flash-Next 的 3 bit 版(記憶體約 78GB),也能跑 5.7 bit 的 oMLX 版,上下文開到 26 萬 token 都跑得過,記憶體最高約 112GB。Mac 的 GPU 預設只能用約四分之三記憶體,餘裕很小,同時開別的程式會爆。
沒有 DGX Spark,只有 Mac 能做地端 AI Agent 嗎?
可以。我自己就在把 MacBook 做成可以斷網單機運作的 AI Agent 設備。文字模型在 Mac 上很快,生圖和語音慢一些但能用,只要選對 MLX 版的語音模型就能補回不少速度。