Article
企業想自建私有 AI?能在自己機器跑、資料不出門的大模型怎麼選
想自建私有 AI 的單位,我實測後建議先評估 NVIDIA 發表的 Nemotron 3.5 Super 120B。它能在自己的機器上跑,看得懂文字、圖片、影片,上下文最高一百萬 token,資料不必離開機房。我在 GB10 上量到生成 16 到 64 tok/s,落地頁做得出來,寫遊戲則輸給 Qwen 3.8 125B。
我是雲哥 Darks,自己開發 AI Agent,這一年把不少開源大模型都放到自己的機器上實測。這篇只寫我量到的數字和我踩到的邊界,不寫我沒測過的東西。
企業說的私有 AI,到底在要什麼?
我聽過最多的需求只有一句話:「資料不要送出去。」把它拆開來,其實是三件事。
| 做法 | 提問與資料去哪 | 誰控管模型 | 適合什麼單位 |
|---|---|---|---|
| 雲端 AI 服務 | 送到服務商的伺服器 | 服務商 | 資料不敏感、要最高聰明度 |
| 租雲端主機自己架模型 | 在你租的主機上 | 你自己 | 沒有機房、但要自己管模型 |
| 地端私有部署 | 只在你自己的機器上 | 你自己 | 政府、公家、資料敏感的單位 |
第三種最符合「資料不出門」。代價是你要自己買機器、自己維護,聰明度也比不上最頂級的雲端模型。這個取捨我在 雲端 AI vs 地端 AI 怎麼選 裡寫得比較完整,如果你還在猶豫要不要走地端,可以先看那篇。
為什麼我挑 Nemotron 3.5 Super 120B 來測?
我先看的是它是誰做的。這顆模型由 NVIDIA 自己發布,對在意來源的單位來說,「模型是哪家公司做的、檔案從哪裡下載」是第一個要問的問題。
我從 NVIDIA 官方頁面查到的資料如下,數字以官方為準。
| 項目 | 官方頁面寫的 |
|---|---|
| 規模 | 總共 120B 參數,每個 token 只啟用 12B |
| 輸入 | 文字、圖片、影片,輸出是文字 |
| 上下文 | 最高 1M token(提示詞、影像、對話歷史、工具結果和回答共用) |
| 授權 | OpenMDW 1.1,頁面寫明可商用或非商用 |
| 發表時間 | 第三方媒體報導 NVIDIA 在 2026 年 10 月 15 日發表 |
我個人在意的是「省記憶體」。我實際開過,開到一百萬 token 和開到二十六萬 token,佔用的記憶體差不多。一般模型的上下文拉長,快取會跟著暴增,這顆的混合架構(官方寫它結合 Mamba-2、混合專家和注意力層)讓長上下文沒那麼吃記憶體。
這點對企業很實用。一份很長的合約、一整包會議逐字稿,可以一次丟進去,不用先切成很多段。
實測:速度、記憶體、看影片的表現如何?
我的測試環境是 GB10(和 DGX Spark 同級,128GB 統一記憶體),用 vLLM 跑 NVFP4 量化版。要說清楚一件事,我實測的是社群做的去審查版本,不是 NVIDIA 官方原版。去審查版是改過權重的,速度和架構相同,但回答的口徑可能不一樣,這個差別我在後面會再談。
| 項目 | 我量到的結果 |
|---|---|
| 啟動時間 | 從按下開始到可以用,約 11.5 分鐘 |
| 記憶體 | vLLM 上限約 85GiB,權重約 70GiB,上下文快取約 8.5GiB,約可放 35 萬 token |
| 生成速度 | 16 到 64 tok/s,長輸出約 47 到 54 tok/s |
| 讀取速度 | 635 到 3450 tok/s |
| 100K token 的提示詞 | 首字約 61 秒才出來 |
| 中文簡答 | 關閉思考 2.2 秒,開啟思考 3.5 秒 |
| 影片 | 丟進一支二十分鐘的影片,也能處理 |
這張表有兩個地方要提醒。第一,生成速度範圍很大,因為它會隨提示詞和輸出長度變。你自己的用法量出來的數字,才是你要的數字。第二,100K token 的提示詞要等一分鐘才出第一個字,如果你要做即時客服,這個延遲得先評估。
我沒有測到的事情也要講。我沒有拿它處理過整批的公文或合約,也沒有做大規模的多人同時使用測試,所以「幾個人能同時用」我給不出數字。
它的強項和弱項在哪裡?
我給它的評價是「穩,但不是最強」。
強的地方:
- 思考過程節省。不會想個沒完,輸出也精簡。
- 沒有出現我在其他模型遇過的狀況,像是卡在思考裡出不來,或是輸出直接壞掉。
- 網頁落地頁做得出來,品質還行。
- 看得懂影片,二十分鐘的片也處理得了。
- 長上下文的記憶體佔用低。
弱的地方:
- 落地頁和遊戲,都輸給我測過的 Qwen 3.8 125B。
- 遊戲第一版能跑起來,但我重跑生存遊戲那題時,畫面很醜、不能玩、不會攻擊,要一輪輪慢慢調。整體實測下來,它遠輸 Qwen 3.8 125B。
- 去審查口徑測試中,我問了逆向工程相關的題目,沒有拒答,但 8 題裡有 6 題帶了免責話術。
- 我設計的能力探針題,因為給的上下文太少,測不出它真正的實力,這一項我不下結論。
所以我選它的理由不是它最聰明。理由是模型來源清楚、穩定、省記憶體,對資料安全有要求的單位,這些條件比多贏幾分更重要。如果你要的是寫程式、做遊戲這類吃聰明度的工作,我還是建議交給更強的模型。
開源模型「可能回傳資料」的傳聞,該怎麼看?
我在 Facebook 發這個主題時寫過,最近有些開源模型傳出可能偷偷回傳資料。這句話我後來回頭查證,想把它說得更準確一點。
我查到的是資安圈的研究,而不是某個特定模型被抓到的案例。
- 作者 Bruce Schneier 在他的部落格介紹了 ProjectDiscovery 的研究:被改過權重的開源模型(文中提到「abliterated」這類改版)可以藏後門,平常表現正常、通過評測,遇到觸發條件才把資料送出去。
- 另有 arXiv 論文研究類似的攻擊方式,模型透過 Agent 的記憶與網路搜尋工具送出資料。
- 雲端安全聯盟(CSA)的研究筆記建議用 safetensors 格式、固定模型檔的雜湊值、限制推論機器的對外連線。
這幾份資料有個共同點。風險來自「被別人改過的權重」,加上「模型身邊有能連外網的工具」。一個沒有網路、沒有工具權限的模型,沒有辦法自己把資料送出去。
我沒有證據說 Nemotron 或任何一個主流模型會這樣做,我自己也沒對它抓過網路封包。所以我的建議很保守,也很具體,就是部署前自己檢查,不要靠傳聞,也不要靠信任。
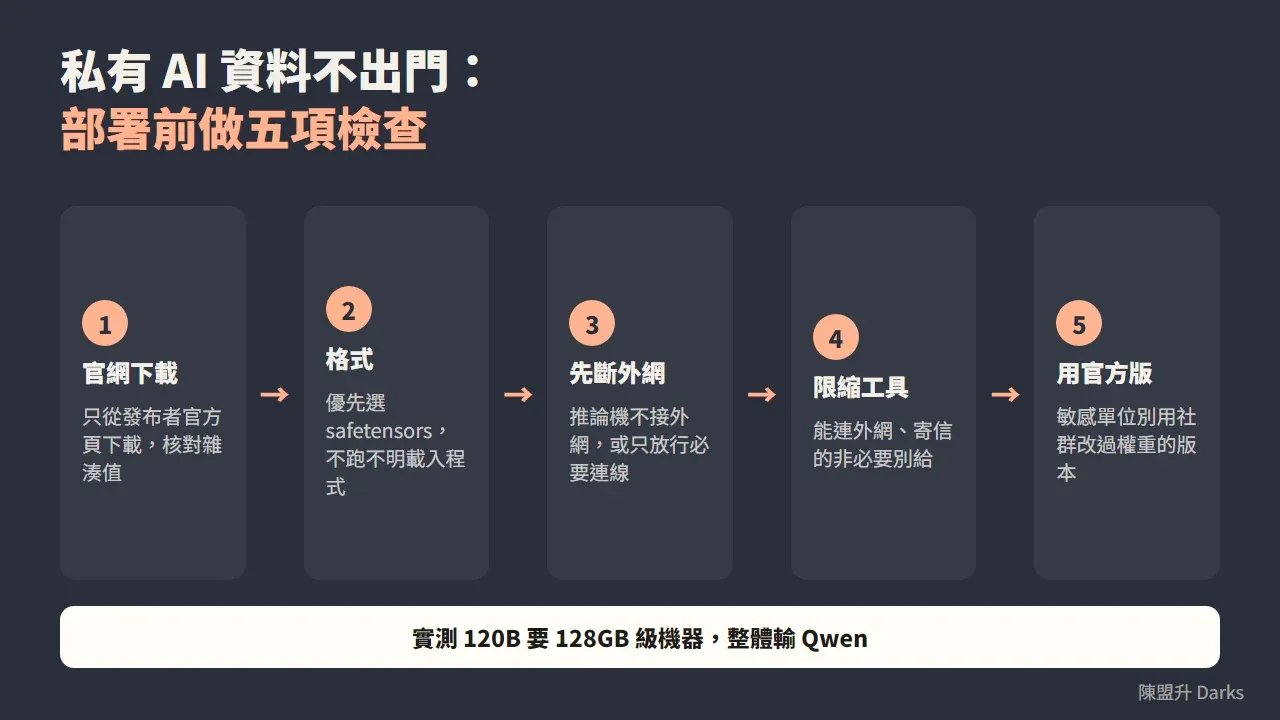
部署前該自己做哪些檢查?
我自己的清單如下,你可以直接拿去給資訊人員參考。
- 只從模型發布者的官方頁面下載,核對檔案雜湊值。
- 優先選 safetensors 格式,不要執行來路不明的模型載入程式。
- 推論用的機器先不接外網,或只放行必要的連線,再看連線紀錄有沒有異常。
- Agent 能用的工具要列清單。能連外網、能寄信、能讀整顆硬碟的工具,沒必要就不要給。
- 敏感單位用官方原版,不用社群改過權重的版本。
- 用你自己的真實使用情境測過,再決定要不要上線。
這也是我對自己那個去審查版的態度。我下載它是為了實測模型真實表現,並且只用在我自己的資料上。如果你擔心,直接用官方原版就好。
這顆模型要多大的機器才跑得動?
以我的實測來看,120B 這個等級的模型,量化後權重就要約 70GiB,再加上上下文快取,需要 128GB 等級的統一記憶體。GB10、DGX Spark 同級的機器,或是 128GB 記憶體的 MacBook Pro 這一類,是比較實際的起點。
如果你的預算或機器還在這條線以下,不用硬上 120B。小一點的模型在 8GB 到 64GB 的機器上也有能跑的選擇,我在 地端 AI Agent 怎麼用 裡寫過不同硬體各自跑得動多大的模型。從零開始選機器、裝環境,可以接著看 地端 AI 環境建置指南。
私有 AI 實際能幫單位做什麼事?
我自己的例子是整理 4680 張螢幕截圖。這些截圖累積快一年,有些不適合給雲端 AI 看,自己一張一張分辨又太花時間,所以一直沒做。
我的做法是讓地端模型寫一支程式,分批把截圖送給地端模型分類,哪些要丟、哪些要留。這裡有個省錢的細節,讓 AI 一張一張看很浪費 Token,讓它寫程式批次處理才有效率。從寫程式到分類,全程都在地端做完,沒有碰到雲端。
這類工作換成單位的情境也通用,像是整批公文歸檔、內部文件分類、會議錄影轉逐字稿與摘要。共通點是量大、規則清楚、內容不想外流。
遇到需要頂級聰明度的工作,像是複雜的程式重構,我還是交給雲端模型。我的分法是敏感資料和大量重複工作留在地端,最難的判斷交給雲端。
從一個小任務開始,建立你自己的私有 AI
我的建議是先挑一個內容敏感、量又大、規則清楚的小任務,拿它在自己的機器上實測,再決定要不要擴大。實驗過自己的使用情境,永遠比看別人的評測準。
如果你想自己開發能跑在私有環境的 AI Agent,我整理了一套 AI Agent 自學網,L0 和 L1 是免費的,可以先從「為什麼要自己做 Agent」開始看。
常見問題 FAQ
私有 AI 和私有部署 AI 是同一件事嗎?
我自己把兩個詞當成同一件事用,意思是模型跑在你自己控管的機器上,提問與資料不經過第三方的雲端服務。差別在機器放哪裡:放在公司機房、辦公室,或租一台自己獨占的主機,都算私有部署,但資料能不能完全不出門,要看那台機器有沒有對外連線。
Nemotron 3.5 Super 120B 需要多大的機器才跑得動?
我是在 128GB 統一記憶體的 GB10(DGX Spark 同級)上,用 vLLM 跑 NVFP4 量化版。實測 vLLM 吃到約 85GiB 上限,其中模型權重約 70GiB,上下文快取約 8.5GiB,大約能放 35 萬 token。如果機器記憶體小於這個量,要改選更小的模型。
開源模型會偷偷把資料傳出去嗎?
我沒有找到能證明某一個主流開源模型會這樣做的公開證據,我自己也沒有對 Nemotron 抓過封包。但有資安研究說明,被人改過權重的模型可以藏後門,在觸發條件出現時透過工具把資料送出去。所以我的做法是部署前自己檢查,用官方原版、核對檔案雜湊、限制網路對外連線和 Agent 能用的工具。
政府或公家單位該用官方原版還是社群去審查版?
對資料安全有要求的單位,我建議用 NVIDIA 官方發布的版本。我自己載的是社群做的無審查版,因為我拿來測模型的真實表現,也只處理自己的資料。社群改過的權重你很難逐一檢驗,敏感單位沒必要冒這個險。
私有 AI 能完全取代雲端 AI 嗎?
以我的實測不行。Nemotron 3.5 Super 120B 做網頁落地頁還可以,做遊戲要一輪輪調,整體輸給 Qwen 3.8 125B,更不用說頂級的雲端模型。我的分法是敏感資料和大量重複工作交給地端,需要最高聰明度的工作再交給雲端。