Article
開源中文 TTS 推薦:我讓 AI Agent 實測 GPT-SoVITS V5、IndexTTS,順便比語音轉文字
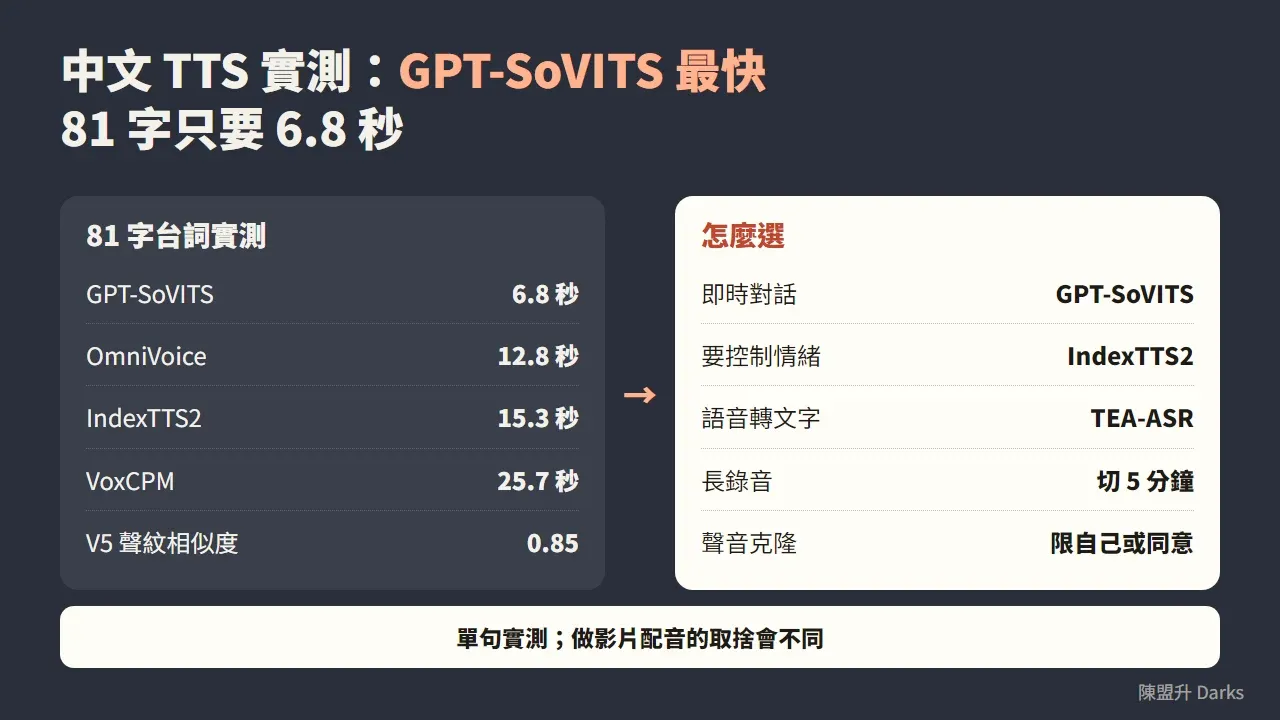
開源中文 TTS 我目前首選 GPT-SoVITS。同一段 81 字台詞,它在 GB10 上 6.8 秒生成完,約是第二名 OmniVoice 的兩倍速;V5 turbo 版聲紋相似度 0.85,生成 1 秒語音只要 0.18 秒。語音轉文字我用 TEA-ASR。聲音克隆只限自己或取得同意的聲音。
TTS 是文字轉語音,Agent 要「開口說話」就靠它。如果你還不確定 Agent 是什麼,先看 AI Agent 是什麼,這篇直接從語音這一塊開始講。
開源中文 TTS 該怎麼選?先想好你要拿來做什麼
我手上有 GPT-SoVITS、OmniVoice、VoxCPM2 輪流用,語音轉文字固定用 TEA-ASR。TTS 用不用得到,要看這台機器有沒有要讓 AI 開口。不需要它說話的時候關掉,記憶體就能讓給別的模型。
我的排序是速度第一,語音清晰與穩定第二,聲音像不像原始聲線排最後。因為我做的是能語音對話的 Agent,回話慢半秒就很有感。
如果你是要幫影片配音,順序會翻過來,要找音色好、穩定度高的,速度反而可以放寬。這個取捨每個人不同,下面的數字你可以照自己的用途重新排。
我是怎麼測的?
幾件事先交代清楚,免得你把數字讀過頭。
- 速度那一輪用的是 GB10(DGX Spark 同級的 128GB 機器),推理速度跟一張 4060 差不多。我參考的另一位測試者用的是 12G 顯存,所以有 12G 以上顯存的卡,這幾款多半都能跑,不一定要 GB10。
- 台詞是 81 字,每款只跑同一段。這是單一句子的結果,不是大量樣本的統計。
- 聲音像不像,我用聲紋相似度當指標,1 代表同一個人。這是機器算出來的數字,聽起來自然不自然另當別論。
- 我沒有另外做台灣口音和中國口音的對照,所以「哪一款的台灣腔最準」我給不出數字。
很多測試是我讓 AI Agent 自己跑的,它反覆調參數,找出最適合的組合,我再看結果。你想複製的話,把專案網址丟給能寫程式的 AI,請它幫你裝與調,會比自己啃文件快。
四款開源 TTS 實測:81 字台詞誰最快?
| 模型 | 81 字台詞生成時間 | 我的使用感受 |
|---|---|---|
| GPT-SoVITS | 6.792 秒 | 最快,聲音穩定;情緒完全取決於參考音 |
| OmniVoice | 12.782 秒 | 整體不錯,但像背稿,該停頓的地方唸很快 |
| IndexTTS2 | 15.301 秒 | 唯一能用文字或參數控制情緒;聲線跟原始音檔差距較大 |
| VoxCPM | 25.719 秒 | 我這次跑到中途缺字、後半句破音、聲音變小 |
VoxCPM 那一列我保守看待。缺字和破音可能是我的設定問題,只是我沒有花時間再研究。所以這張表只代表我這次的測試結果。
GPT-SoVITS 的聲音情緒完全取決於你給的參考音。想要不同情緒,就得準備不同情緒的錄音。我很懶,只用一種平常語氣的錄音,所以聲線會比較平淡。
GPT-SoVITS V5 教學:要準備什麼、效果如何?
GPT-SoVITS 是開源的文字轉語音工具,給它幾秒錄音,就能用那個聲音唸任何句子。V5 剛更新的時候,我讓 Agent 馬上去測,這是同一組參考音、同樣四組聲音的對照。
| 項目 | 舊版 v2 | V5 turbo |
|---|---|---|
| 聲紋相似度(1 是同一人) | 0.77 | 0.85 |
V5 turbo 生成 1 秒語音只要 0.18 秒,出聲模型約吃 2.2GB 顯卡記憶體,加上程式本身合計約 8GB。
V5 有兩個版本,標準版 dev 和速度版 turbo。V5 不用另外訓練,克隆就更像本人,新的出聲模型也少了刺耳的高頻雜音。短句回話不到 1 秒就能出聲,我拿來做語音對話的 Agent 很夠用。
實際上手的步驟很短。
- 到官方 GitHub 專案 RVC-Boss/GPT-SoVITS 看最新版說明。
- 準備一段乾淨的參考錄音,官方資料寫幾秒就能做零樣本克隆,想更像再用約一分鐘資料微調。
- 選 turbo 或 dev。要即時對話選 turbo,要多一點品質再試 dev。
- 把專案網址交給你的 AI Agent,請它安裝、跑起來、調參數,你只要聽結果。
這個流程對其他 TTS 也通用。換成別的模型,步驟一樣是看官方說明、備參考音、請 Agent 裝與調、自己聽。
IndexTTS 比 GPT-SoVITS 更像本人嗎?
我做過兩輪對照。舊聲線下,IndexTTS 比較像,聲紋相似度 0.87 對 0.77;速度上 GPT-SoVITS 約快 3 倍,也比較省記憶體。換成正式服務用的 v2ProPlus 比,結果一樣,IndexTTS 0.87 對 0.83,GPT-SoVITS 快約 3 倍。
IndexTTS-2.0 在 GB10 上經過優化後,講 1 秒語音從 1.02 秒降到 0.38 秒,聲紋相似度從 0.65 升到 0.89,記憶體從 11.1GB 降到 8.1GB。
所以像不像和快不快是兩條路。IndexTTS2 官方宣稱能同時控制情緒和語音時長,情緒可以用參考音、文字描述或情緒向量指定,也能把音色與情緒分開設定。我自己用文字調情緒,效果不大,這是我選 GPT-SoVITS 的原因之一。你如果需要情緒變化,可以自己試試。
台灣用戶要注意哪些中文問題?
最直接的雷是 Irodori-TTS。我實測它講不出中文,3 句中文分成繁體、簡體、片假名音譯,以及繁體加「說中文」描述四種寫法各測一次,漢字都被當日文念。Whisper 判 12 段全是日文,內容吻合度只有 0.09 到 0.41。加描述沒有用,片假名拼音只有短句聽得出來。
這是有日文強項的模型,但要中文語音就別選它。同一個模型,我拿來唸日文是正常的,7 句日文的第一句 1.0 秒就出聲。選模型前,先用你要的語言跑一句,比看介紹準。
至於口音,GPT-SoVITS 的聲音取決於參考音,理論上用台灣口音的錄音當參考音,輸出會偏向那個聲線。我沒有做口音量化對照,這點請自己聽。
開源語音轉文字怎麼選?我用 TEA-ASR
我跟 AI 溝通大部分是直接講,轉成文字再送出去,所以語音轉文字一定常開。我用的是 TEA-ASR,它是社群開發者針對台灣華語和中英夾雜微調的開源模型,以 Qwen3-ASR 為基礎,授權資料寫 MIT,基底模型是 Apache-2.0。
實際用起來是這樣。
- 我常常一次講 3 到 5 分鐘,轉錄大約 30 秒,短句更快。
- 繁中識別效果很好,中英夾雜也應付得來。
- 長錄音要切段。我拿 39 分鐘的錄音,切成每段 5 分鐘內,共 9 段,124.8 秒全部轉完,約 8028 字。同一份錄音拿 20 分鐘整段一次送,只回 994 字,掉了大約四分之三。
- 標點會影響閱讀。我後來加了中文標點模型,把「就,是」「測,試」這種硬切的逗號修掉,一段 39 秒的錄音原本沒有句號,修完有 3 個。
所以長錄音別整份丟進去,切成 5 分鐘一段,結果會穩得多。
Mac 上能跑這些語音模型嗎?
我的 MacBook Pro M5 Max(128GB)也跑得動。11 月初我讓 Agent 把語音換成 Apple 晶片專用的 MLX 版,速度又往前一大步。
| 項目 | 換 MLX 前 | 換 MLX 後 |
|---|---|---|
| TEA-ASR(6.5 秒語音) | 0.67 秒 | 0.21 秒 |
| TEA-ASR 顯存 | 14.6 GiB | 5.6 GiB |
| IndexTTS 2.0 即時係數(RTF,越小越快) | 1.44 | 0.52 |
| IndexTTS 2.0 顯存 | 40 GiB | 14 GiB |
同一批句子,語音轉文字在 Mac 是 0.18 秒,GB10 是 0.62 秒,Mac 快 3.4 倍。GPT-SoVITS 則是 GB10 快,0.14 秒對 Mac 的 0.26 秒。
升級到 macOS 27.2 之後我還踩到一個坑。PyTorch 的 MPS 在半精度下算錯,語音轉文字吐空白,IndexTTS 出現重複字,我改用全精度才恢復正常。如果你在 Mac 上遇到語音輸出怪怪的,可以先檢查是不是半精度的問題。
聲音克隆開源要注意什麼?
只克隆自己的聲音,或取得本人明確同意的聲音。
GPT-SoVITS 只要幾秒錄音就能做出很像的聲音,這代表有心人也能拿別人公開的影片去做。冒用熟人聲音打電話、錄影片詐騙這類事已經發生,我另外寫過 AI 聲音偽造詐騙怎麼防。如果你要把克隆聲音用在影片、課程或客服,建議在說明裡標註是 AI 合成。
要怎麼把 TTS 接到你的 AI Agent?
語音對話要三塊串起來,語音轉文字、大模型、文字轉語音。TTS 通常放最後一棒,所以速度會直接影響「說完話到聽到回答」的等待感。
我的做法是三個都在本地跑。一台機器有足夠記憶體,大模型、語音轉文字、TTS 和嵌入模型可以同時開著。硬體怎麼配、哪個模型吃多少記憶體,我寫在 本地 AI 環境建置指南;本地模型能幫你做哪些事,看 地端 AI Agent 能做什麼。
這套做法對其他情境也通用。換成客服語音、有聲書、學習軟體的朗讀,都是同樣的三塊,差別只在你選哪一款 TTS。
先讓你的 Agent 開口說第一句話
建議照這個順序開始。
- 先裝好語音轉文字,用講的跟 AI 交代一件事。
- 從 GPT-SoVITS 開始,備一段自己的錄音當參考音。
- 如果覺得聲音太平淡,再試 IndexTTS2 的情緒控制。
- 每換一款模型,先用你真正要用的語言和句子測一次。
我測了四款以上的 TTS,但最後留下來的是最快的那一款。你的答案可能不同,用自己的需求去排序就好。
常見問題 FAQ
開源中文 TTS 現在推薦哪一款?
如果你要讓 AI Agent 即時開口說話,我推薦 GPT-SoVITS。同一段 81 字台詞,我在 GB10 上測到它 6.792 秒生成完,OmniVoice 12.782 秒、IndexTTS2 15.301 秒、VoxCPM 25.719 秒。要用文字或參數控制情緒,可以看 IndexTTS2。這是以即時對話為前提的選擇,做影片配音的人考量點會不同。
GPT-SoVITS 需要多少顯卡記憶體?
我實測 V5 的出聲模型約吃 2.2GB 顯卡記憶體,加上程式本身合計約 8GB,所以顯存較小的顯卡也有機會跑得動。這是我在 DGX 上量到的數字,你的環境和設定不同,數字會有出入。
聲音克隆要準備多長的錄音?
GPT-SoVITS 官方資料寫的是幾秒的參考錄音就能做零樣本克隆,想更像可以再用約一分鐘的資料微調。V5 在我的測試裡不另外訓練,克隆的相似度就比舊版 v2 高,0.85 對 0.77。克隆只限自己的聲音,或取得本人同意的聲音。
開源 TTS 能商用嗎?
各專案授權不同。GPT-SoVITS 的 GitHub 專案掛的是 MIT 授權;IndexTTS2 和 VoxCPM2 的 Hugging Face 模型卡寫 Apache-2.0;OmniVoice 的程式碼和模型權重授權我查到的資料不一致。商用前請直接看各專案官方 repo 的 LICENSE,不要只看第三方整理。
開源語音轉文字推薦哪一個?
我自己用 TEA-ASR,它是針對台灣華語與中英夾雜微調的開源模型。我常常一次講 3 到 5 分鐘,轉成文字大約 30 秒,短句更快。長錄音我會切成每段 5 分鐘內再送,39 分鐘的錄音切 9 段,共 124.8 秒轉完。
Irodori-TTS 能講中文嗎?
我實測講不出來。3 句中文分別用繁體、簡體、片假名音譯各測一次,漢字會被當成日文念,Whisper 判 12 段全是日文,內容吻合度只有 0.09 到 0.41。如果你要的是中文語音,這個模型不適合。