Article
Strata 引擎教學:顯存不夠也能跑大模型?12GB 顯卡要配多少記憶體,我用 GB10 實測 125B
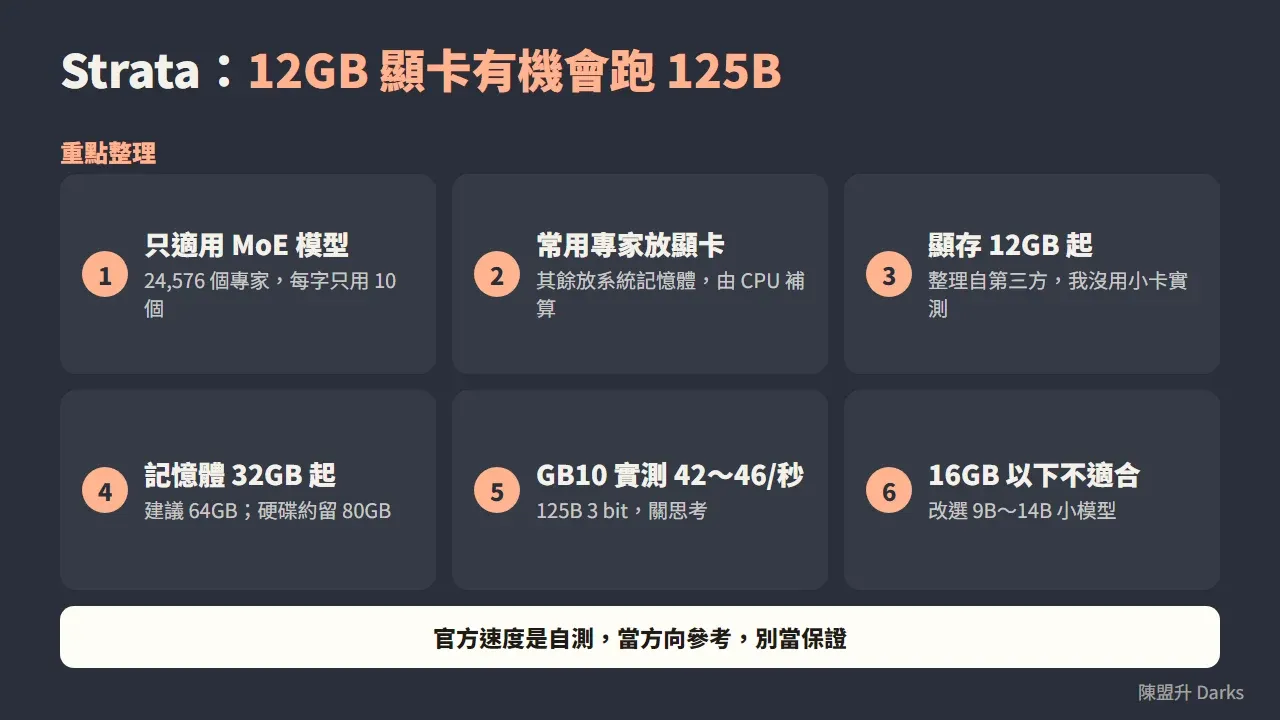
Strata 是開源的 MIT 授權推理引擎,用來在一般電腦上跑 125B 這種大型 MoE 模型。做法是把最常用的專家放進顯示卡,其餘留在系統記憶體,所以顯存只要 12GB 左右就有機會跑,代價是系統記憶體要夠。我在 GB10 上用它跑 125B,生成約每秒 42 到 46 個 token,下面一併說清楚低顯存的人要準備什麼。
先講我的來路。我平常用 GB10(128GB 統一記憶體)和 MacBook 跑地端模型,Strata 是我跑 125B 的主力引擎,這些數字都是我自己量的。至於 8GB、12GB 的獨立顯卡,我沒有親自測過,那部分我整理的是官方文件和第三方評測,會標明出處。
Strata 是什麼?
Strata 的專案在 GitHub 的 Niko1221/Strata,MIT 授權,免費、不用註冊帳號。它基於 llama.cpp 和 ggml,提供 OpenAI 與 Anthropic 相容的本機 API,所以接上你現有的聊天工具或 AI Agent 不用改太多。
目前 README 列出的模型有三個。
| 模型 | 說明 |
|---|---|
| Qwen3.8-Flash-Next | 125B 的 MoE 模型,Strata 最初就是為它做的 |
| Qwen3.6-35B-A3B | 較小的 MoE 模型,記憶體壓力小很多 |
| DeepSeekV4.1-Flash-1017 | 很大,磁碟需求約 197 到 280GB,記憶體不夠的部分會從 SSD 讀 |
支援的硬體也比我原本想的廣。README 列了 NVIDIA RTX 20、30、40、50 系列,AMD Radeon 和 Ryzen AI Max,Apple Silicon(M1 以上),還有 DGX Spark 和 Intel Arc。程式會在第一次啟動時下載對應顯示卡的引擎。
為什麼顯存小也能跑大模型?
關鍵在 MoE(混合專家)這種模型的特性。以 Qwen3.8-Flash-Next 來說,整個模型有 24,576 個專家,但每生成一個字只會用到其中 10 個。
所以不需要把全部專家都塞進顯卡。依 BestHub 的原理整理,Strata 的做法是這樣。
- 約 4,000 個最常用的專家放在顯示卡。
- 全部專家都放在系統記憶體,顯卡上沒有的,由 CPU 幫忙算。
- 另有一份約 29GB 的查找表放在 SSD,每個字只讀很少的資料。
- 再加上投機解碼,讓小模型先猜幾個字、大模型一次驗證,官方宣稱可快 1.6 到 1.8 倍。
白話講,常用的調味料擺在流理台,其他的收在儲藏室,要用再去拿。顯卡的容量只管流理台,儲藏室由系統記憶體負責。
這個原理只適用 MoE 模型。一般的稠密模型每個字都要用到全部參數,沒有「常用」和「不常用」之分,顯存小就是跑不動。整套地端 AI 該怎麼配記憶體,我整理在 地端 AI 推薦配置。
低顯存的人要準備什麼硬體?
顯存可以小,系統記憶體還是要夠。這是整篇最重要的一句話。
SmartScope 的整理 引用的官方最低需求,是至少 12GB 顯存、32GB 記憶體、約 80GB 硬碟空間、支援 AVX2 的 CPU,NVIDIA 驅動要 580 以上。建議 64GB 以上記憶體,並用 NVMe 硬碟。
| 你的記憶體 | 第三方整理建議的版本 |
|---|---|
| 32GB | 以 Coder 版為標準選擇 |
| 48GB | IQ2_XS 或 Q2_0 |
| 64GB | IQ2_XS 為主,也能用 IQ3_XXS、IQ3_S |
| 96GB 以上 | IQ3_S 或 UD-IQ4_XS |
這張表有幾點要小心。
- Coder 版在中文任務上表現較弱,BestHub 的整理 建議中文使用者選保留全部專家的量化版。
- 8GB 顯存有說法是能跑但很慢,也有人用 6GB 的 RTX 2060 搭 32GB 記憶體,因為放不下專家快取而啟動失敗(GitHub issue #916)。
- 第一次載入約 35 到 55GB 資料進記憶體,電腦可能卡 1 到 3 分鐘,別以為當機。
- 專案 2026 年 9 月才公開,還在快速更新,安裝前請看官方最新說明。
如果你的記憶體只有 16GB,Strata 這條路恐怕走不通,我建議直接選 9B 到 14B 的小模型。想用 LM Studio 這類簡單工具上手,可以看 LM Studio 本機模型教學。
我在 GB10 跑 125B 的實測數字
我的 GB10 有 128GB 統一記憶體,跟你的獨立顯卡架構不同,所以這裡的數字是「Strata 這顆引擎本身表現如何」的參考,不是 12GB 顯卡的預期值。
我用的是社群微調的 Qwen3.8 125B(3 bit 量化版),262K 上下文,量測結果如下。
| 項目 | 我的實測 |
|---|---|
| 生成速度(關思考) | 約每秒 42 到 46 個 token |
| 開思考的長輸出 | 約每秒 60 到 66 個 token |
| 讀入 1.6 萬 token | 首字約 10 秒 |
| 讀入 6.4 萬 token | 首字約 30 到 41 秒 |
| 冷啟動 | 約 30 秒 |
| 顯卡上的引擎峰值 | 約 57GiB |
模型載入之後,我的 128GB 還剩約 50GB,足夠同時開語音轉文字、語音合成和嵌入模型,所以我可以拿它當 AI Agent 的大腦長時間常駐。
還有一個我很實用的功能是多對話快取。Strata 預設只記得「正在聊的那一段」,兩段對話輪流進來時,前一段的快取會被擠掉,得重讀。我開了快取停車位之後,兩段真實對話輪流使用,等第一個字的中位數從 13.9 秒降到 1.8 秒。
MacBook M5 Max(128GB)我也跑過同一顆模型,生成約每秒 78 到 92 個 token,比 GB10 快將近一倍,但讀 6.4 萬 token 的首字要約 47 秒,比 GB10 慢。兩台機器的完整比較,我寫在 DGX Spark 和 MacBook M5 Max 跑本地大模型的實測。
官方公布的速度,你可以怎麼看
官方在 RTX 5070(12GB)、4K 上下文的自測數字,依量化不同大約落在每秒 53 到 94 個 token,量化越小越快,品質也越低。這些是專案自己公布的數字,我沒有在同樣的卡上重現,也沒看到獨立的第三方對比。
我的建議是,把它當作「方向」,不要當作「保證」。你的記憶體頻寬、CPU、上下文長度都會讓結果不同,官方自己也寫明一個上下文長度的數字不能直接套到另一個長度。
適合與不適合的人
適合的情況。
- 你有 12GB 以上顯存,也有 64GB 左右的系統記憶體,想在本機跑 100B 以上的 MoE 模型。
- 你要拿它當 AI Agent 的大腦,重視資料不外流,能接受每秒幾十個 token 的速度。
- 你願意看 GitHub 文件和 issue,遇到問題自己排查。
不適合的情況。
- 系統記憶體只有 16GB 以下,或硬碟空間不夠放約 80GB 的模型。
- 要穩定的商業服務。專案很新、沒有穩定版本標籤,BestHub 也建議先當實驗工具。
- 主要用中文,又只能選 Coder 版的人。
怎麼開始
我只寫官方文件已經列出的路徑,細節請以 官方 GitHub 為準。
- 到官方頁面下載桌面版(Windows、Linux、Mac 都有),或用 README 提供的終端機安裝指令。
- 依你的記憶體大小選量化版本,別一開始就挑最大的。
- 用
strata launch啟動,用strata connect連接你的工具。 - 預設只綁定本機 127.0.0.1:8080,如果要開放給別台電腦用,官方強烈建議先設定 API key。
遇到啟動失敗或記憶體不足,先看官方的 TROUBLESHOOTING.md。
讓跑起來的大模型真的幫你做事
我用 Strata 是因為需要一顆能常駐、又不用把私人資料交給別人的大腦。大模型在自己電腦跑起來只是第一步,接上工具、記憶和流程,它才會變成能做事的助手。如果你還不清楚 Agent 跟聊天機器人差在哪,可以先看 AI Agent 是什麼。
常見問題 FAQ
Strata 是什麼?
Strata 是 MIT 授權的開源推理引擎,專門讓大型 MoE 模型能在一般消費級電腦上跑。它把常用的專家放在顯示卡,其餘放在系統記憶體,所以顯存不用裝下整個模型。官方 README 目前支援 Qwen3.8-Flash-Next(125B)、Qwen3.6-35B-A3B 和 DeepSeekV4.1-Flash-1017。
顯存不夠 8GB 或 12GB,可以用 Strata 跑大模型嗎?
12GB 顯卡是我查到的各方整理一致列出的最低門檻,搭配至少 32GB 系統記憶體,建議 64GB。8GB 有說法是能跑但很慢,也有 6GB 顯卡因為放不下專家快取而啟動失敗的回報。我自己沒有拿小顯存顯卡實測,這部分是整理別人的資料。
Strata 跑大模型,記憶體要多大?
顯存可以小,系統記憶體還是要夠。第三方整理的建議是 32GB 起跳、64GB 比較舒服、96GB 以上可以選品質較好的量化版。模型檔本身約 70GB,硬碟也要留約 80GB。
Strata 和 llama.cpp 差在哪?
Strata 以 llama.cpp 和 ggml 為基礎,llama.cpp 也能用參數把專家放到 CPU 跑。Strata 的主打是針對特定 MoE 模型做專家快取與投機解碼,速度數字由官方自己量測,目前我沒看到公開的同機對比,所以速度優勢要自己實測才算數。
Mac 可以跑 Strata 嗎?
官方 README 列出 Apple Silicon(M1 以上)支援。我自己的 MacBook M5 Max 128GB 有實測,跑同一顆 125B 模型,生成速度約每秒 78 到 92 個 token。