Article
本地 AI 生圖、影片、音樂模型推薦:我在 ComfyUI 實測後留下的組合(2026)
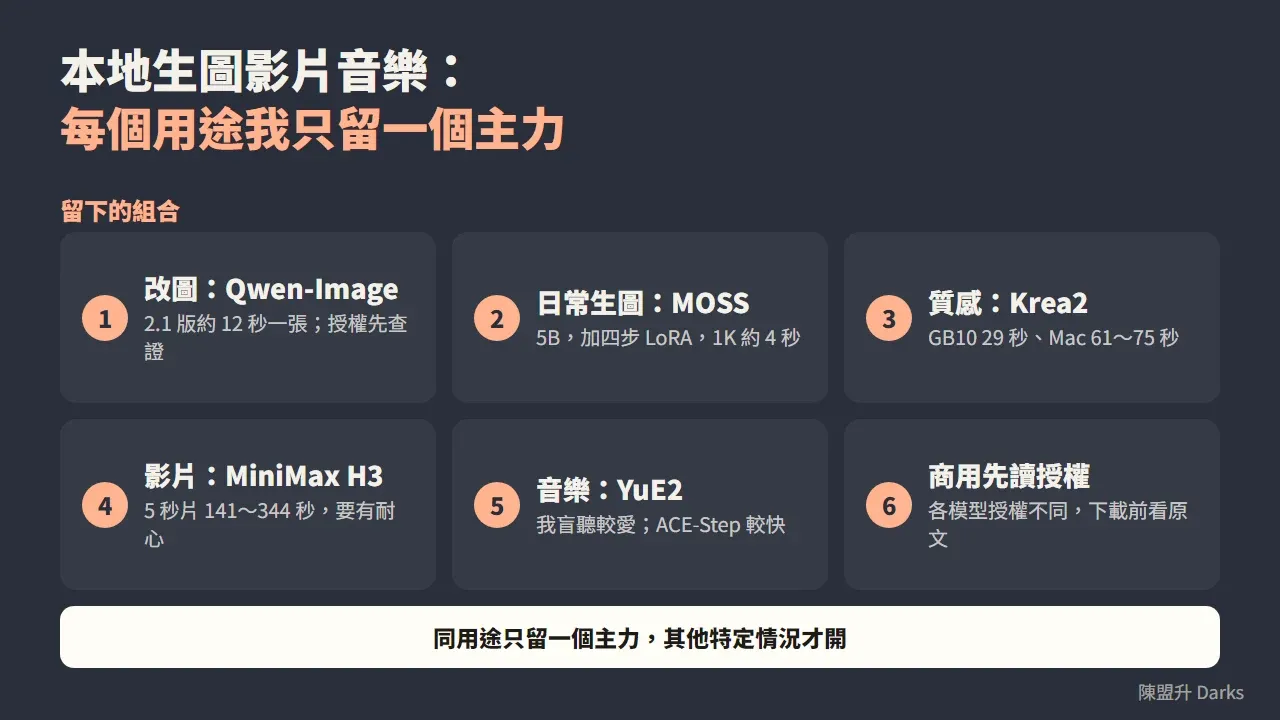
本地 AI 圖片生成,我現在留下圖片編輯用 Qwen-Image 2.1、日常生圖用 MOSS-Image 或 Krea2、影片用 MiniMax H3、音樂用 YuE2 加 ACE-Step 1.5。MOSS-Image 只有 5B,加四步 LoRA 後 1K 圖約 4 秒一張,都是我在 GB10 與 MacBook 實測的。
這篇講的是裝在自己電腦上的 ComfyUI 模型。如果你的重點是用雲端免費額度出商品圖,可以先看AI 產品圖提示詞。如果你還沒決定要買什麼機器,先看本地 AI 環境怎麼架,再回來挑模型。
我現在留下哪些本地模型?
這張表是我目前常駐在 ComfyUI 裡的清單。同一個用途我通常只留一個主力,其他的只在特定情況才開。
| 用途 | 我留下的模型 | 實測速度 | 授權(查證結果) |
|---|---|---|---|
| 圖片編輯 | Qwen-Image 2.1 | 整張改圖約 12 秒一張(GB10) | 多個來源說是 Qwen 研究授權,非商用 |
| 日常生圖 | MOSS-Image 5B | 1K 約 4 秒,2K 約 20 秒 | Apache 2.0 |
| 質感生圖 | Krea2(Turbo) | GB10 29 秒、Mac 61 到 75 秒 | Krea2 社群授權 |
| 影片 | MiniMax H3 | 5 秒影片 141 到 344 秒 | MiniMax H3 社群授權 |
| 音樂 | YuE2、ACE-Step 1.5 | 一首歌 55 到 165 秒 | CC BY-NC 4.0、MIT |
這份清單我也寫在過去一篇 FB 貼文裡,是我拿到 128GB 機器之後一路調出來的。你不用照抄,同類型的用途,換成你手上跑得動的模型,做法都一樣通用。
本地 AI 圖片生成,MOSS-Image 為什麼適合小顯存?
我是 2026 年 10 月開始玩 MOSS-Image 的,它是 OpenMOSS 團隊在 10 月 16 日釋出的 5B 開源文生圖模型,據官方 GitHub 說明,權重與推理程式碼用 Apache 2.0 授權。
我的實測環境是算力約 5060、5070 等級的機器,1K 的立繪一張約 4 秒,16:9 的 2K 桌布約 20 秒。模型只有 5B,一般小顯存的電腦也跑得起來。我在 GB10 上量到的峰值顯存約 11 GB。
我自己覺得好用的有三點。
- 裝上四步 LoRA 就能幾秒出一張,我實測品質跟一般 25 步差不多。
- 用 JSON 框框排版,每一塊放什麼人、寫什麼字都能指定,做中文海報很方便。
- 提示詞裡有國名、地名時,模型會自己把字寫在圖上,這點要先知道。
用法交給 AI Agent 最省事。我是直接叫 Agent 去找 MOSS-Image 的四步 LoRA,模型和節點讓它一次裝好。
同一個模型,加速做法差多少?
我在 2026 年 10 月 28 日跑過一輪加速比較,一共出了 358 張圖,沒有失敗,峰值記憶體 11.7 GiB。這輪我測的是 MOSS 社群版本,尺寸 1024×1536。
| 做法 | 一張要多久 | 和不加速的畫面相似度 |
|---|---|---|
| 4 步 LoRA | 5.6 秒 | 沒有量 |
| 8 步 | 8.8 秒 | 沒有量 |
| 50 步不加速 | 91.8 秒 | 基準 |
| 50 步加 EasyCache 0.12 | 57.8 秒 | 0.976 |
| 50 步加 EasyCache 0.2 | 40.2 秒(快 2.3 倍) | 0.957 |
| 50 步加 EasyCache 0.4 | 35.7 秒 | 0.941,場景會壞 |
我的看法是,日常出圖直接用 4 步,連中文字都能全對。要出精品圖、想要皮膚和細節更好的時候,才用 50 步加 EasyCache 0.2。0.4 太省了,場景會出問題,我不用。
Qwen-Image 2.1 適合拿來改圖嗎?
適合,而且我把它當圖片編輯的主力。Qwen-Image 2.1 是 2026 年 9 月 20 日開源的,多個來源提到它是 7B 的圖片生成與編輯模型。
我當天用 1376×768 生一張只要 23 秒,之前用的生圖模型要 60 秒。繁體字全對,沒有糊也沒有崩。這是我在 FB 貼文上留下的第一手紀錄。
後來我拿它做了幾輪改圖測試,結果如下。
- 改建築招牌上的中文字,旗子單字三次都對。
- 給它一張人像照片當臉部參考,再用同一句提示詞只換照片,6 張出來是 6 個不同的人。不給照片、只換種子的 6 張,臉幾乎一樣。改圖一張 12.3 秒,文字生圖同題 6.2 秒。
- 換身、換衣服、換背景這類改圖,我拿千問和另一個 8 步的 Klein 模型比,兩邊打平,但換衣服和保持角色一致,千問比較穩。
MOSS-Image 的參考圖做法拿來改圖,我試過是不行的,場景、頭像、雙人都失敗。所以我的分工是 MOSS 負責從頭生圖,千問負責改圖。
授權要特別提醒。我查到多個來源說 Qwen-Image 2.1 改用 Qwen 研究授權,只允許非商用,商用要另外跟阿里申請,跟前代 Qwen-Image 的 Apache 2.0 不同。我沒有辦法直接開到官方授權頁確認原文,所以你要拿來商用的話,請自己去模型頁讀一遍。
Krea2 在 GB10 和 Mac 上差多少?
Krea2 是 Krea 在 2026 年 6 月 22 日釋出的開源權重生圖模型,有 Raw 和 Turbo 兩個版本,大約 12B 參數,用 Krea 自己的社群授權。我查到的說法是,商用條件和公司規模、使用人數有關,各家報導寫的門檻不太一致,所以我只建議你直接看官方 GitHub 的授權說明。
我用它的原因是畫面質感好、很逼真。我在 7 月的貼文記錄過,4060 等級的算力跑一張大約 20 到 40 秒,小顯存可以載 GGUF 版省顯存。我自己在 GB10 上跑的是 Turbo 的 INT8 版,一張也是 20 到 40 秒。
2026 年 11 月 5 日我把同一套流程裝到 MacBook Pro M5 Max 128GB 上,1888×1056、8 步的作者流程,結果是這樣:
| 機器 | 一張要多久 | 備註 |
|---|---|---|
| GB10(DGX Spark) | 29 秒 | 同一個流程 |
| MacBook Pro M5 Max | 61 到 75 秒 | 慢約 2.3 倍,連跑會越來越慢,峰值記憶體約 31GB |
| MacBook Pro M5 Max(1024×1024) | 約 27 秒 | 畫質正常 |
Mac 能跑,但 INT8 在它上面是用反量化的方式模擬,所以比較慢。我後來裝了一個 Apple Silicon 的加速套件,對官方 int8 模型有效,一張從 70.5 秒降到 41 秒;但對另一個 fp8 的版本沒用,還慢了 9%。所以 Mac 用戶挑模型版本時要看清楚它是哪種精度。
想知道這兩台機器怎麼選,我另外整理了DGX Spark 對 MacBook M5 Max 的比較。
生完要放大,用哪個比較好?
我現在放大主要用 SeedVR2,ByteDance Seed 做的圖片影片修復放大模型,Comfy 官方文件寫 3B 和 7B 都是 Apache 2.0 授權,ComfyUI 有內建節點可以用。
2026 年 10 月我拿小圖放大 2 倍,1K 放大 2 倍,3B 約 4.5 秒,7B 約 6.5 到 8.6 秒,放大到 4096×2304 約 20 秒。文字不會重影,臉和頭髮更清楚。
但我 11 月又補測了一次,發現它不是什麼都行。拿含有大片布料皺褶和皮膚的特寫,同種子同參數,SeedVR2 7B 放大 1.5 倍約 27 秒,皺褶會變成拉鍊或皺紙那種密紋,顏色偏暗偏褐,5 張裡有 4 張看得出來。改用 Krea2 重畫放大,皺褶自然、顏色也維持,但要約 47 秒,構圖會小幅變動。
我的選法是,有字、有臉的圖用 SeedVR2,大面積質感的特寫用重畫。10 月那次我只測了字、臉和構圖,沒測大面積質感,這是我當時測試的盲點。
本地 AI 影片生成,MiniMax H3 要等多久?
MiniMax H3 的開放權重是 2026 年 8 月 3 日釋出的,ComfyUI 同天就有原生支援,要用 ComfyUI 0.30.0 以上版本,在範本裡找 MiniMax H3。我查到報導說它的社群授權不是 OSI 認定的開源授權,而且排除了美國等地區,所以商用請先讀授權原文。
我在 DGX 上用官方工作流的原始設定,生 5 秒影片的時間是這樣:
| 設定 | 生成時間 |
|---|---|
| 原版 | 344 秒 |
| 8 步 | 176 秒 |
| 4 步 | 141 秒 |
4 步只比 8 步快一點,沒有減半,而且有機率畫面或聲音有瑕疵,要自己衡量。想用 8 步或 4 步,記得 turbo_mode 要改成 true。官方範本有圖生影片、文生影片、參考圖生影片三種,小顯存只要記憶體夠也能用,只是更慢。
HyperFlow H3 Flash 有比較快嗎?
HyperFlow H3 Flash 是 Video Rebirth 在 2026 年 11 月 6 日釋出的壓縮版,把 H3 的 transformer 壓到約 13.7B,4、6、8 步就能出片。我 11 月 10 日拿它跟我原本用的 4 步加速版比了一輪,768×896、124 格:
| 項目 | 原本的 4 步加速版 | HyperFlow 4 步 | HyperFlow 6 步 |
|---|---|---|---|
| 首幀轉影片 | 152 秒 | 166 秒 | 170 秒 |
| 首尾幀轉影片 | 217 秒 | 176 秒 | 170 秒 |
在 GB10 上它每步並沒有比較快,作者說的加速我沒換到時間。我換到的是動作幅度比較大,顯存也少了幾 GiB。換成參考圖影片的做法,它的取樣比原本快約 17%,手揮動時不會拖影,背景有淺景深。
後來我又試了兩段式做法,先用小尺寸跑,再放大一倍重畫,三條工作流驗證下來,首幀版 155 秒、首尾幀版 133 秒、參考圖版 259 秒,峰值顯存 31.8 到 36.2 GiB。我已經把一般影片的預設換成這套。其中第二段的步數是我自己訂的,作者沒有給。
本地 AI 音樂生成,YuE2 和 ACE-Step 怎麼選?
這兩個我都留著,因為取捨很明確。
ACE-Step 1.5 是 ACE Studio 和 StepFun 做的,論文寫它在 4GB 以下的顯存就能跑,授權是 MIT。YuE2 是 m-a-p 團隊的歌詞轉歌曲模型,3.58B 參數,權重是 CC BY-NC 4.0,也就是非商用。
我在 2026 年 10 月 22 日用 7 種曲風加 4 首指定主題的歌,各跑一遍,中日英都有,女聲、快節奏、約 3 分鐘:
| 項目 | ACE-Step 1.5 | YuE2 |
|---|---|---|
| 一首要多久 | 55 到 63 秒 | 78 到 165 秒 |
| 峰值顯存 | 20.3 GB | 12.9 GB |
| 歌曲長度 | 照指定 | 2 分 16 秒到 4 分 03 秒 |
| 要重抽的比例 | 0 / 11 | 2 / 11(截斷、重複) |
| 語言 | 中日英全對 | 中日英全對 |
2026 年 10 月 24 日我自己盲聽,大部分歌曲比較喜歡新版 YuE2,只有少數幾首 ACE-Step 比較好,但 ACE-Step 仍有明顯的電音感。我就把日常用的音樂生成換成 YuE2,ACE-Step 留著做快速試聽。
如果你要拿歌去商用,YuE2 的非商用授權要先想清楚,ACE-Step 1.5 比較沒有這個限制。
我自己也有踩過的坑
這幾件事是我實測時學到的邊界,一般教學很少寫。
- 速度數字都綁機器。我的數字來自 GB10 和 M5 Max,你的顯卡不同,請當參考。
- 作者建議的步數不一定適合我的機器。HyperFlow 就是這樣,官方講加速,我在 GB10 上沒換到時間。
- 一個流程測過一次不代表永遠對。SeedVR2 我 10 月測了字和臉,11 月才發現大面積質感會劣化。
- 加速參數有上限。EasyCache 0.4 相似度掉到 0.941,場景就壞了。
- 所有授權我都是查網路資料,不是律師。商用前請讀官方原文。
想讓 AI Agent 自己呼叫這些模型怎麼做?
這是我把本地模型留下來的最大原因。這些模型我自己很少手動點 ComfyUI,大部分是叫 AI Agent 去載模型、裝節點、排隊生圖,做完才通知我。MOSS-Image 的四步 LoRA 是 Agent 幫我找的,影片也是排進背景跑。
這件事要成立,需要三塊。一台記憶體夠大的機器,模型才放得下,我的 128GB 同時開著大語言模型、生圖、語音轉文字、語音合成和嵌入模型,就是一台多模態的 AI Agent。再來是一個調好的 Agent。最後是你願意讓它做事的流程。
機器怎麼選、環境怎麼架,我寫在本地 AI 環境怎麼架。Agent 能做什麼、能放什麼工作給它,看地端 AI Agent 能做什麼。
官方來源與授權,下載前自己核對一次
下面是我查證用的來源。模型更新很快,授權也可能改,下載前請以官方頁面為準。
- MOSS-Image:OpenMOSS/MOSS-Image GitHub,權重在 Hugging Face 的 OpenMOSS-Team。
- Qwen-Image 2.1:阿里 Qwen 團隊的 Hugging Face 模型頁,授權請看模型頁的 LICENSE。
- Krea2:krea-ai/krea-2 GitHub,權重是 krea/Krea-2-Raw 與 krea/Krea-2-Turbo。
- MiniMax H3:Hugging Face 的 MiniMaxAI/MiniMax-H3,ComfyUI 版是 Comfy-Org/MiniMax-H3。
- HyperFlow H3 Flash:Hugging Face 的 VideoRebirthAI/hyperflow-h3-flash。
- ACE-Step 1.5:arXiv 2602.00744。
- SeedVR2:ComfyUI 官方文件。
- YuE2:m-a-p 團隊的 Hugging Face 模型頁,授權寫在模型卡。
常見問題 FAQ
本地 AI 圖片生成最少要多少顯存?
看模型。我實測的 MOSS-Image 是 5B 參數,GPU 算力大約 5060、5070 等級的一般電腦就能跑,我量到峰值顯存約 11 GB。Krea2 在 4060 等級顯卡上我看到的是一張 20 到 40 秒,小顯存可以改載 GGUF 版本。這些是我自己或雲端網友的實測,你的機器請以自己跑出來的數字為準。
ComfyUI 推薦模型,新手先裝哪一個?
如果你想先體驗生圖,我會建議從 MOSS-Image 開始,因為它小、速度快,加上四步 LoRA 之後 1K 圖大約 4 秒一張。想要圖片編輯、換視角、改字,再另外裝 Qwen-Image 2.1。不用一次全裝,記憶體和硬碟都會被吃掉。
這些開源模型可以拿來商用嗎?
不能一概而論。ACE-Step 1.5 是 MIT 授權,MOSS-Image 是 Apache 2.0,但 Qwen-Image 2.1 據多個來源的說法是研究用授權,YuE2 的權重是 CC BY-NC 4.0 非商用,Krea2 和 MiniMax H3 則是各自的社群授權。商用之前請到官方模型頁讀授權原文。
本地 AI 影片生成現在實用嗎?
能用,但要有耐心。我在 DGX 上實測 MiniMax H3 生 5 秒影片,原版 344 秒、8 步 176 秒、4 步 141 秒。4 步只是快一點,還有機率出現畫面或聲音瑕疵。我的用法是排進背景跑,讓 Agent 做完再叫我看。
本地 AI 音樂生成要選 YuE2 還是 ACE-Step?
我自己盲聽的結果是大部分歌曲比較喜歡 YuE2,ACE-Step 1.5 的電音感比較明顯,但它快很多,一首約 1 分鐘。如果你要商用、或機器只有小顯存,ACE-Step 1.5 的授權和門檻比較友善。
Mac 可以跑 ComfyUI 生圖嗎?
可以,只是比較慢。我用 MacBook Pro M5 Max 128GB 跑 Krea2,同樣流程一張 61 到 75 秒,GB10 是 29 秒,大約慢 2.3 倍。想看兩台機器怎麼選,可以看我另外寫的 DGX Spark 對 MacBook M5 Max 比較。